AI Observability for Large Language Model Systems — Twinkll Sisodia의 관측성 분류
목차
가령 한 답변은 12초 만에 도착하고, 다른 답변은 1초 만에 도착했지만 사실과 달랐다고 하자. 두 요청 모두 HTTP 200으로 끝났다면 어느 쪽이 정상인가? 지연만 보는 대시보드는 첫 번째 요청을 잡는다. 정답을 판정하는 평가만 있다면 두 번째 요청을 잡는다. 둘 중 하나의 숫자로 두 문제를 설명할 수는 없다.
Twinkll Sisodia의 AI Observability for Large Language Model Systems: A Multi-Layer Analysis of Monitoring Approaches from Confidence Calibration to Infrastructure Tracing(arXiv:2604.26152v1, 2026년 4월 28일)은 이런 차이에서 출발한다.
논문은 모델 내부, 확신도 보정, 행동 감시, 운영 지능, 인프라 추적이라는 다섯 층에 관련 연구를 배치한다. “AI를 관측하자”는 말만으로는 막연하지만, 이렇게 나누면 어떤 증거를 모을지 따져 볼 수 있다.
저자는 다섯 연구를 비교해 분류하고 앞으로의 방향을 제안했다. 다섯 층을 연결한 시스템을 구현하거나 그 시스템으로 오류 원인을 찾는 실험까지 하지는 않았다.
논문의 비교표도 서로 다른 데이터와 지표를 한자리에 놓은 것이지 동일 조건의 성능 대결이 아니다(원문 §2, §4와 Table 1–2, 2·6·8쪽).
각 층에서 무엇을 확인하고 무엇은 알 수 없는지 먼저 나눠 보자.
| 관측 대상 | 확인할 질문 | 이것만으로 모르는 것 |
|---|---|---|
| 실행 추적·인프라 | 어느 단계에서 지연이 생겼나 | 답의 사실성 |
| 확신도 보정 | 확신도와 실제 정답률이 맞나 | 개별 답의 정답 보장 |
| 내부 표현 | 입력의 어떤 관계가 복원되나 | 현실의 사실 여부 |
| 행동 감시 | 관찰 자료에서 특정 행동이 드러나나 | 모든 내부 사고 과정 |
| 운영 평가 | 주입한 장애를 해결했나 | 모든 운영 환경의 성능 |
같은 요청에도 두 가지 질문이 있다
먼저 “왜 늦었나”를 묻는다면 요청이 어느 단계에서 시간을 썼는지 알아야 한다. 대기, 입력 처리, 첫 토큰 생성, 이후 토큰 생성, 노드 간 통신을 분리하지 않은 총 지연만으로는 병목을 찾기 어렵다. 논문이 추적 층에 놓은 TRUFFLD는 추론 엔진의 사건과 GPU 실행 사건을 연결해 요청별 호출 구조를 재구성하는 연구다. 조사하는 것은 실행 단계와 연산자다. 느린 연산자를 찾으면 지연 원인을 좁힐 수 있지만, 답이 사실과 다른 이유까지 알 수는 없다(원문 §3.5, 5쪽).
반대로 “왜 틀렸나”를 묻는다면 먼저 무엇을 정답으로 셀지 정해야 한다. 검증 가능한 질문과 판정 기준이 없으면 정답률도, 확신도 보정도 계산할 수 없다. 모델의 자체 확신도는 답이 맞을 가능성에 관한 신호이고, 문서 검색 결과와 모델 내부 표현은 입력을 어떻게 다루는지에 관한 신호다. 서비스 지연이나 GPU 지표와 같은 자리에 그래프를 그릴 수는 있어도, 그 수치들이 같은 대상을 측정하는 것은 아니다.
논문의 다섯 층도 물리적 호출 순서와 꼭 맞지 않는다. 모델 내부·확신도·행동은 관찰할 신호, 인프라 추적은 실행을 볼 위치, 운영 지능은 그 자료로 조사·판단할 역할에 가깝다.
예컨대 AIOpsLab은 운영 장애를 주입하고 에이전트를 평가하는 환경이지, 앞의 네 신호를 이미 묶어 운영하는 제품이 아니다. 이 차이를 놓치면 “다섯 층을 갖추면 원인을 알 수 있다”는 결론으로 너무 빨리 넘어간다(원문 Figure 1과 §3.4, 2·4–5쪽; AIOpsLab 출판본 §2–3).
확신도 0.8은 “이 답이 맞다”가 아니다
잘못된 답변을 다룰 때 논문이 소개하는 RLCR(reinforcement learning with a calibration reward)가 눈에 들어온다. 일반적인 정답 보상에 보정 손실을 더해, 모델이 답과 함께 숫자형 확신도 q를 내도록 학습한다. 정답이면 1, 오답이면 0인 값 c에 대해 보상은 c − (q − c)²다.
예를 들어 오답인데 q=0.8이라면 보정 손실은 (0.8−0)²=0.64이고, 정답이라면 (0.8−1)²=0.04다. 높은 확신으로 틀릴수록 불이익이 커진다.
같은 확신도 묶음에서 정답이 나올 비율을 p라고 하자. 보정 손실의 기대값은 p(q−1)² + (1−p)q² = (q−p)² + p(1−p)다. p가 고정되어 있으면 q=p일 때 가장 작다. 즉 이 손실은 실제 정답 비율과 맞는 확신도를 장려한다. 이 계산은 고정된 답 분포에서 보정 항이 하는 일을 보여 주며, 실제 훈련이 모든 질문 분포에서 완벽한 보정을 달성한다는 보증은 아니다. 보상 정의: Damani 외, §3
보정이 무엇인지 작은 가상 예시로 계산해 보자. 질문 20개를 모델이 붙인 확신도에 따라 두 묶음으로 나눴다.
| 묶음 | 질문 수 | 모델의 확신도 | 맞힌 질문 수 | 실제 정답률 | 확신도와 정답률의 차이 |
|---|---|---|---|---|---|
| 높은 확신 | 10 | 0.8 | 6 | 0.6 | 0.2 |
| 낮은 확신 | 10 | 0.3 | 3 | 0.3 | 0 |
기대 보정 오차(ECE)는 각 묶음의 차이를 그 묶음의 비중만큼 더한 값이다.
ECE = (10/20 × |0.8−0.6|) + (10/20 × |0.3−0.3|) = 0.1앞 묶음의 확신도를 0.8에서 0.6으로 바꾸면 ECE는 0이 된다. 그런데 정답은 여전히 20개 중 9개다.
지표를 설명하려고 확신도 숫자만 사후에 고친 예다. RLCR은 훈련으로 보정을 학습하므로, 위 계산으로 그 과정이나 결과를 재현한 것은 아니다.
이 예에서 ECE 0은 “각 답이 맞다”가 아니라 “이 확신도 묶음에서 말한 비율과 실제 맞은 비율이 같다”는 뜻이다. 0.6 묶음의 오답 네 개는 그대로 남는다. 표본을 어떻게 구간으로 나눴는지, 어떤 질문이 들어왔는지에 따라 ECE도 달라진다.
RLCR 원 연구는 확신도를 10개 구간으로 묶어 ECE를 계산했고, 정의된 평가 조건에서 HotpotQA의 ECE가 0.37에서 0.03으로, 수학 문제 모음에서는 0.26에서 0.10으로 내려갔다고 보고한다. HotpotQA 표에서는 RLVR과 RLCR의 정확도가 각각 63.0%, 62.1%다. “정확도를 유지하면서 보정을 개선했다”는 요지는 이 범위에서 읽어야 한다(Damani 외, §4.2–4.3, Table 1 및 ECE 정의).
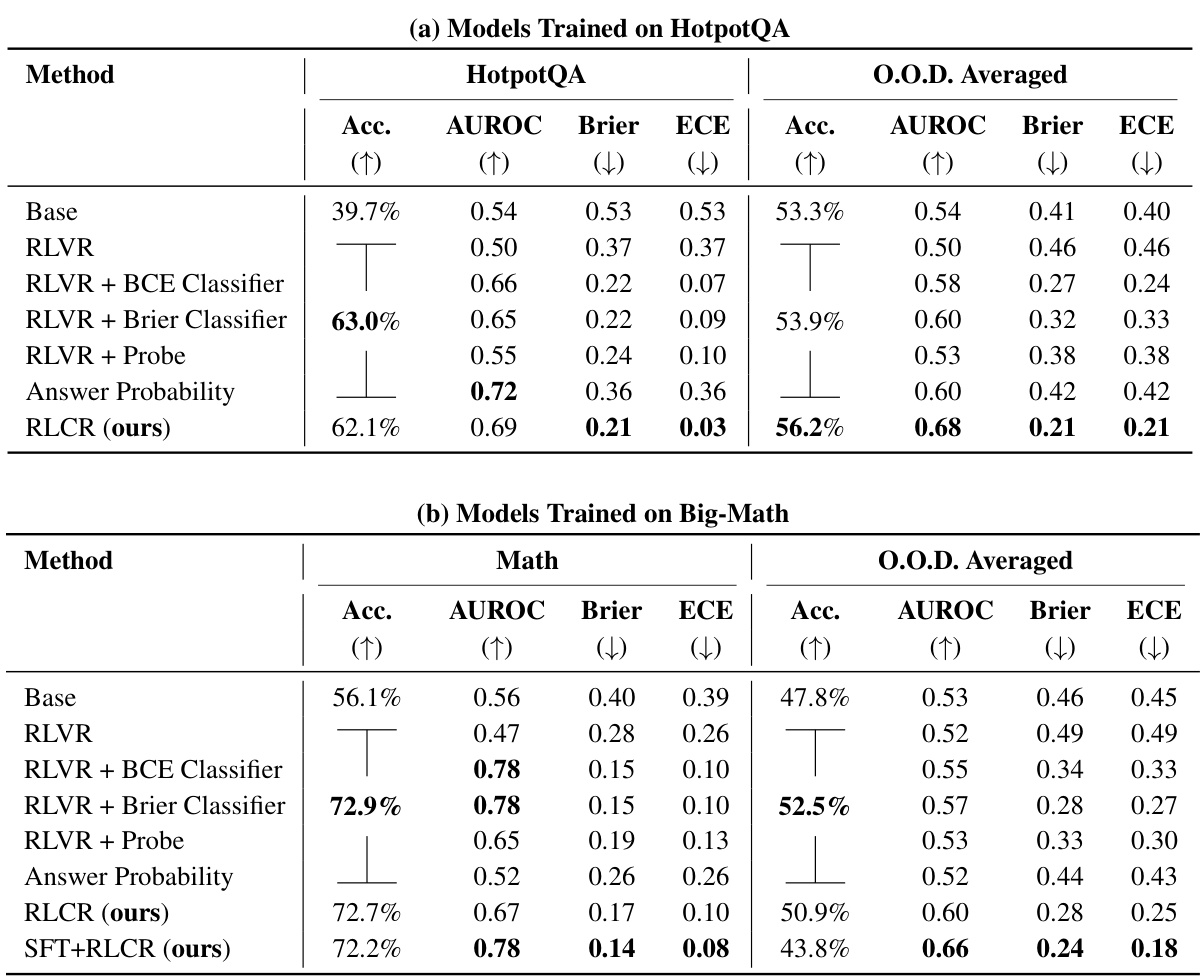
Mehul Damani 외, Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty, arXiv:2507.16806v2, PDF 7쪽 표 1, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
위쪽 (a)는 HotpotQA로, 아래쪽 (b)는 Big-Math로 학습한 결과다. 각 묶음에서 Acc.는 클수록, ECE는 작을수록 좋다. 오른쪽 O.O.D. 열은 학습 분포 밖 평가이므로 왼쪽 결과와 섞지 않는다. 본문에서 비교한 값만 옮기면 다음과 같다.
| 학습·평가 묶음 | RLVR 정확도 / ECE | RLCR 정확도 / ECE |
|---|---|---|
| HotpotQA | 63.0% / 0.37 | 62.1% / 0.03 |
| Big-Math의 Math 평가 | 72.9% / 0.26 | 72.7% / 0.10 |
ECE는 크게 내려갔지만 정확도가 함께 상승한 두 행은 아니다. 모델이 답의 정오 가능성을 더 잘 표현하는 것과 정답을 더 많이 맞히는 것을 따로 읽어야 한다.
그래서 q < 0.3이면 무조건 사람에게 넘기라는 운영 규칙은 논문에서 나오지 않는다. 그 임계값으로 보내는 요청의 수, 놓치는 오답의 수, 검토 비용을 실제 질문 분포와 함께 재야 한다. 모델이나 프롬프트가 바뀌면 보정을 다시 확인해야 한다. 확신도가 낮은 이유가 질문 난도인지, 입력 자료 부족인지, 실행 환경 문제인지는 q 하나로 구별할 수 없다.
“모델 안에 있었다”와 “세상에서 참이다” 사이
확신도가 답의 정오 가능성을 묻는다면, 내부 표현 탐침은 더 좁고 다른 질문을 던진다. Feng·Russell·Steinhardt의 propositional probes는 입력 문장에 나타난 개체와 관계를 모델 활성화에서 복원한다. 원 논문의 예를 빌리면 “Greg는 간호사다”라는 입력에서 WorksAs(Greg, nurse)를 읽어내는 식이다. 간단한 영어 문장으로 탐침을 훈련하고 이야기체·스페인어 입력, 프롬프트 주입 등의 조건에서 관계 복원을 평가했다(원 연구 §3, §6 및 Table 1).
출력이 입력을 왜곡해도, 내부 표현에서는 입력의 관계를 복원할 수 있다는 결과다. 다만 탐침의 정답은 입력 문맥에 담긴 관계다. “Greg는 간호사다”라는 문장 자체가 거짓이면, 탐침이 그 관계를 정확히 읽어도 현실의 직업을 확인한 것은 아니다.
더구나 그 표현을 모델이 최종 답을 만들 때 실제로 사용했는지, 모든 도메인에서 같은 방식으로 읽히는지는 별개의 질문이다. 이 연구를 “모델 안에서 환각의 진짜 원인을 찾았다”고 바꾸어 쓰면 실험의 경계를 넘는다.
내부 활성화에 접근할 수 있어야 한다는 조건도 있다. 외부 API로 답만 받는 서비스에서는 같은 탐침을 그대로 붙일 수 없다. 탐침을 고르기 전에 내부 활성화에 접근할 수 있는지, 검증에 쓸 라벨이 있는지 확인하자. 입력 문맥을 충실하게 읽었는지 확인하는 일과 외부 사실의 진위를 가리는 일에는 서로 다른 라벨이 필요하다.
CoT를 볼 수 있어도 내부 생각을 읽은 것은 아니다
모델이 출력한 풀이 과정(CoT, chain of thought)과 도구 호출을 볼 수 있다면 행동 감시를 시도할 수 있다. Guan 외의 Monitoring Monitorability는 모니터가 관찰 자료를 보고 지정된 행동 속성을 맞힐 수 있는지를 측정한다. 예컨대 평가자가 알고 있는 특정 개입이나 결과 속성을 모니터가 알아채는가를 묻는다.
원 연구는 CoT를 제공할 때 행동만 제공하는 경우보다 대체로 감시 가능성이 높아지는 결과를 보고한다(§2, §4).
여기서 **감시 가능성(monitorability)**과 **충실성(faithfulness)**을 분리해야 한다. 모니터가 “이 답에는 지정한 속성이 있다”고 잘 분류해도, 출력된 풀이 과정이 모델의 내부 계산을 그대로 기록했다는 뜻은 아니다. 반대로 풀이 과정에 유용한 단서가 있어도 모니터가 언어·형식·길이를 해석하지 못하면 그 속성은 감시되지 않는다. 원 논문은 감시 가능성을 모델과 모니터 양쪽에 의존하는 속성으로 정의하고, 외부에 드러난 추론이 내부 추론에 충실할 것을 정의상 요구하지 않는다고 명시한다(Guan 외, §2.1).
지표도 평가 과제에 맞춰 읽어야 한다. 일반적인 이진 속성 평가는 탐지 대상 중 찾아낸 비율인 TPR과 비대상 중 정상으로 판정한 비율인 TNR을 곱한 g-mean² = TPR × TNR을 쓴다. 그러나 개입 평가에서는 개입이 실제로 일으킨 효과를 고려한 TPR_mc와 개입·대조 집단 각각의 TNR을 결합한다. 조사 대상 사건이 드문 운영 환경에서 탐지 점수 하나를 그대로 “사고를 막을 확률”로 읽을 수 없는 까닭이다(Guan 외, §3.1.1–3.1.2). 논문이 언급한 후속 질문의 개선도 설계된 질문에 강하게 의존한다. 임의의 일반 질문 한 번은 개선이 거의 없었고, 일부 조건에서는 오히려 악화됐다(§7).
운영 알림에는 사건이 얼마나 드문지도 영향을 준다. 다음은 논문의 실험값이 아닌 설명용 계산이다. 요청 10,000개 중 감시 대상 행동이 100개이고, 탐지기가 TPR=0.9, TNR=0.99라고 하자.
| 실제 상태 | 요청 수 | 경고한 수 | 경고하지 않은 수 |
|---|---|---|---|
| 감시 대상 행동 있음 | 100 | 90 | 10 |
| 감시 대상 행동 없음 | 9,900 | 99 | 9,801 |
TPR × TNR은 0.891이지만, 경고 189개 중 실제 대상은 90개로 약 47.6%다. 이 두 값은 모순이 아니다. 앞의 값은 대상과 비대상을 각각 얼마나 잘 구별하는지 조합한 점수이고, 뒤의 값은 울린 경고를 얼마나 믿을 수 있는지다. 대상이 드물면 작은 오탐 비율도 많은 경고를 만든다. 사람에게 보낼 경고량을 정할 때는 탐지 점수와 함께 실제 사건 비율을 알아야 한다.
로그를 모은 다음에도 정답은 저절로 나오지 않는다
운영 지능 층의 AIOpsLab에서는 마이크로서비스 환경에 장애와 워크로드를 만들고, 에이전트에게 로그·메트릭·트레이스와 조작 인터페이스를 준다. 에이전트가 장애를 탐지하고 위치·원인을 찾아 완화하는 과제를 비교하는 평가 환경이다.
원 출판본에는 문제 풀 100개 중 비용 때문에 대표 문제 48개를 골랐다고 적혀 있고, 네 에이전트의 전체 정확도는 15.25~59.32%였다(Chen 외, §3.3 및 Table 3, 7–8쪽). 이 숫자는 주입한 장애와 정해진 평가 기준 아래의 성적이다. 현실의 동시 장애나 빠진 로그까지 해결했다는 성능으로 옮겨 적을 수 없다.
| 평가한 에이전트 | 평균 실행 시간 | 전체 정확도 |
|---|---|---|
| GPT-4-W-SHELL | 28.61초 | 49.15% |
| GPT-3.5-W-SHELL | 12.44초 | 15.25% |
| REACT | 43.79초 | 55.93% |
| FLASH | 99.64초 | 59.32% |
Chen 외, AIOpsLab MLSys 2025 출판본 표 3의 네 에이전트와 두 지표를 재구성했다. 등록 코드 줄 수·단계 수·토큰 수 열은 생략했다.
가장 짧게 실행한 GPT-3.5-W-SHELL의 정확도가 가장 낮고, 가장 오래 실행한 FLASH의 정확도가 가장 높았다. 이 결과에서 판단할 수 있는 것은 같은 평가 환경의 시간·정확도 교환관계다. 모델 크기나 로그의 양 한 가지만으로 원인을 설명하는 실험은 아니다.
이 리뷰 논문은 이 결과를 “자료의 부재보다 텔레메트리 해석이 병목”이라는 방향으로 해석한다(§3.4, 5쪽). 벤치마크 안에서는 비교할 만한 관찰이다. 운영 현장에서는 먼저 로그가 실제로 남았는지, 요청별로 묶이는지, 누락 구간은 어디인지 확인해야 한다. 자료가 없는 상황과 자료는 있지만 해석이 틀린 상황은 해결책이 다르다.
함께 그린 그래프는 원인 증명이 아니다
이제 처음의 두 요청으로 돌아가자. 12초짜리 답변의 trace ID로 모델 버전, 입력 길이, 대기 시간, 토큰 생성 시간과 실행 단계의 이상을 묶으면 지연이 나타난 위치를 좁힐 수 있다. 1초짜리 오답에는 판정 가능한 정답 라벨, 그 답의 확신도, 참조한 입력과 출력 행동을 붙여야 한다. 식별자·시간 범위·완료 상태·표본 분모가 맞아야 이 자료들을 함께 놓고 조사하기가 수월하다.
하지만 낮은 확신도와 GPU 압박이 같은 시각에 보였다고 해서 후자가 전자의 원인은 아니다. 어려운 질문은 입력이 길고 생성도 오래 걸릴 수 있고, 배치·재시도·모델 버전도 두 수치에 함께 영향을 준다.
논문의 “이전에 계산한 키·값을 보관하는 KV 캐시의 축출이 낮은 확신도를 만들었는가”라는 문장은 실증 결과가 아니라 교차 계층 연구를 제안하는 질문이다(§5.2 Gap 1, 7쪽).
검증하려면 같은 질문 묶음과 모델·디코딩 설정을 고정하고, 통제된 부하 조건을 교차 배정해 지연 변화가 먼저 있는지 봐야 한다. 그다음 완료된 요청의 확신도와 정답률이 달라지는지 비교하고, 타임아웃·실패는 별도 분모로 센다. 그래도 차이가 보인다면 버전·배치·수치 연산 등의 대안을 더 확인해야 한다. 이런 실험을 실제로 수행한 것은 아니다. 상관관계를 보고 원인을 주장하려면 적어도 이 정도의 검증이 필요하다는 제안이다.
이 논문을 설계도로 받아들일 때 가장 조심할 대목도 여기에 있다. 인프라의 실행 상태를 모델의 확신도·행동 변화와 연결하는 것은 이 논문이 제안한 연구 방향이며, 입증한 진단 절차가 아니다. 각 원 연구의 지표는 정답률, 보정 오차, 명제 복원, 지정 속성 감시, 장애 진단, 연산 단계 탐지처럼 서로 다른 질문에 답한다. 한 요청에서 모두 수집할 수 있다고 해도 하나의 “관측성 점수”로 더할 근거는 없다(원문 Figure 2와 §4.1–5.2, 6–8쪽).
내가 이 분류를 운영 설계에 옮긴다면 먼저 장애 문장을 두 개로 쪼개겠다. “응답이 늦다”에는 요청별 시간 분해와 실행 추적의 접근권을, “답이 틀리다”에는 검증 가능한 라벨과 해당 질문 분포에서의 보정 검사를 요구한다. 그다음에야 둘을 같은 요청으로 연결할지, 어떤 개입으로 원인 가설을 시험할지 정할 수 있다. 다섯 층의 신호를 전부 모으기 전에 지금 가진 증거로 무엇을 알 수 있는지부터 따져 보자. 그다음에야 더 모을 자료를 정할 수 있다.