Awesome AI Engineering — Eric-LLMs의 자료로 평가부터 공부하기
목차
에이전트가 파일을 저장했다고 답했다. 문장은 자연스럽고 경로도 그럴듯하다. 하지만 파일이 없거나, 파일은 만들었어도 수정하면 안 되는 다른 파일을 건드렸다면 작업은 성공한 것일까.
awesome-ai-engineering의 도구 목록을 보기 전에 무슨 결과를 성공으로 인정할지부터 정해 보자. 성공 조건이 있어야 모델과 프레임워크도 고를 수 있다. 평가에서는 에이전트의 말과 실제 결과를 나누고, 기억에서는 저장한 정보가 다음 요청에 쓰이기까지의 순서를 살펴본다.
Awesome AI Engineering은 GitHub의 Eric-LLMs 계정에서 공개한 자료 모음이다. 아래에서는 commit cc834a89c2d0의 평가·메모리 자료를 다룬다.
이 저장소에서 무엇을 얻을 수 있나
모델 추론, 검색, 도구, 기억, 평가를 한눈에 훑기에는 이 자료가 편하다. README도 첫 그림을 개념 지도라고 명시한다. 다만 지도에 나온 구성 요소를 모두 도입할 필요는 없다.
파일 목록에는 실행 진입점이나 서비스 구현 대신 README, 라이선스, PDF 7개와 그림 7개가 있다. 따라서 저장소 자체의 처리량이나 장애 복구를 평가할 수는 없다. Delveta와 LLMs-Lab의 기능 설명은 외부 프로젝트 소개이므로 해당 소스를 따로 읽기 전에는 구현 사실로 확정하지 않는다.
전체 지도를 그대로 구현하면 당장 필요 없는 부분까지 운영하게 된다. 평가할 질문을 먼저 만들고, 그 질문에 필요한 구성 요소를 찾아 읽는 순서가 낫다. 자료로 선택지를 찾은 뒤 실제 도입 여부는 해결할 실패와 근거를 보고 정하면 된다.
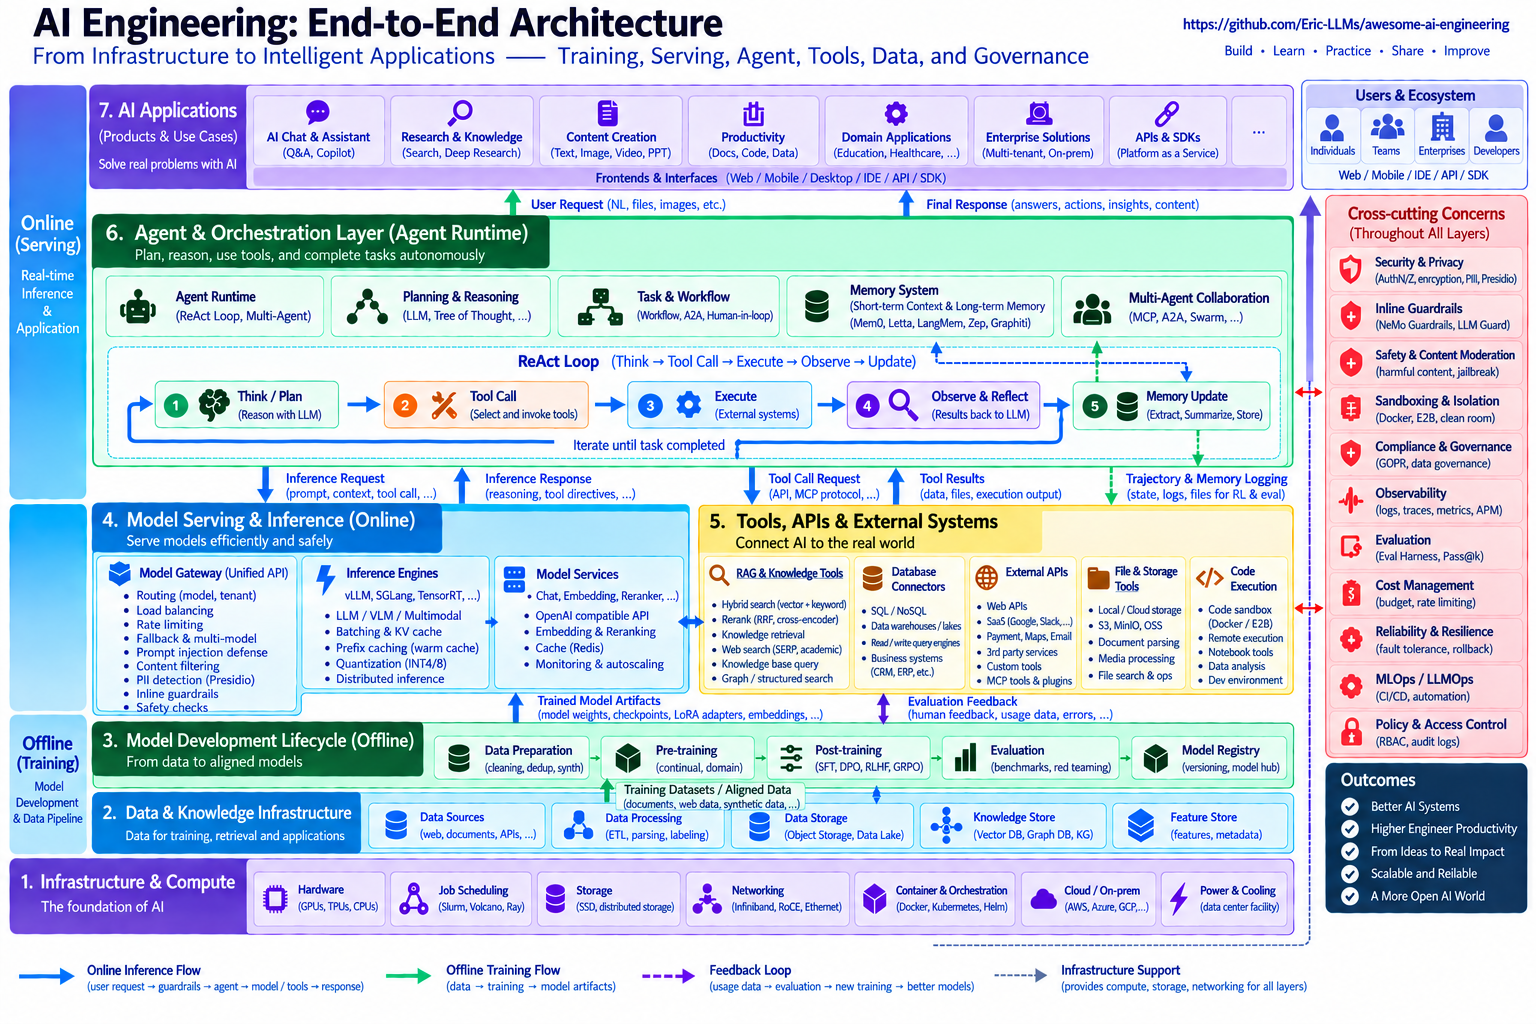
Eric-LLMs, AI Engineering: End-to-End Architecture. 원본 그림, CC BY 4.0. 원본 PNG를 변경 없이 실었다. 누르면 확대할 수 있다.
그림의 위쪽 녹색 영역은 에이전트의 실행 루프, 그 아래 노란 영역은 도구가 바꾸는 외부 환경이다. 오른쪽의 평가는 이 둘을 가로지른다. 이 글에서 따라갈 연결도 도구 실행 → 환경 변화 → 결과 판정이다. 나머지 계층과 제품명은 가능한 구성 요소를 찾는 지도이며, 모두 갖춰야 하는 필수 목록은 아니다.
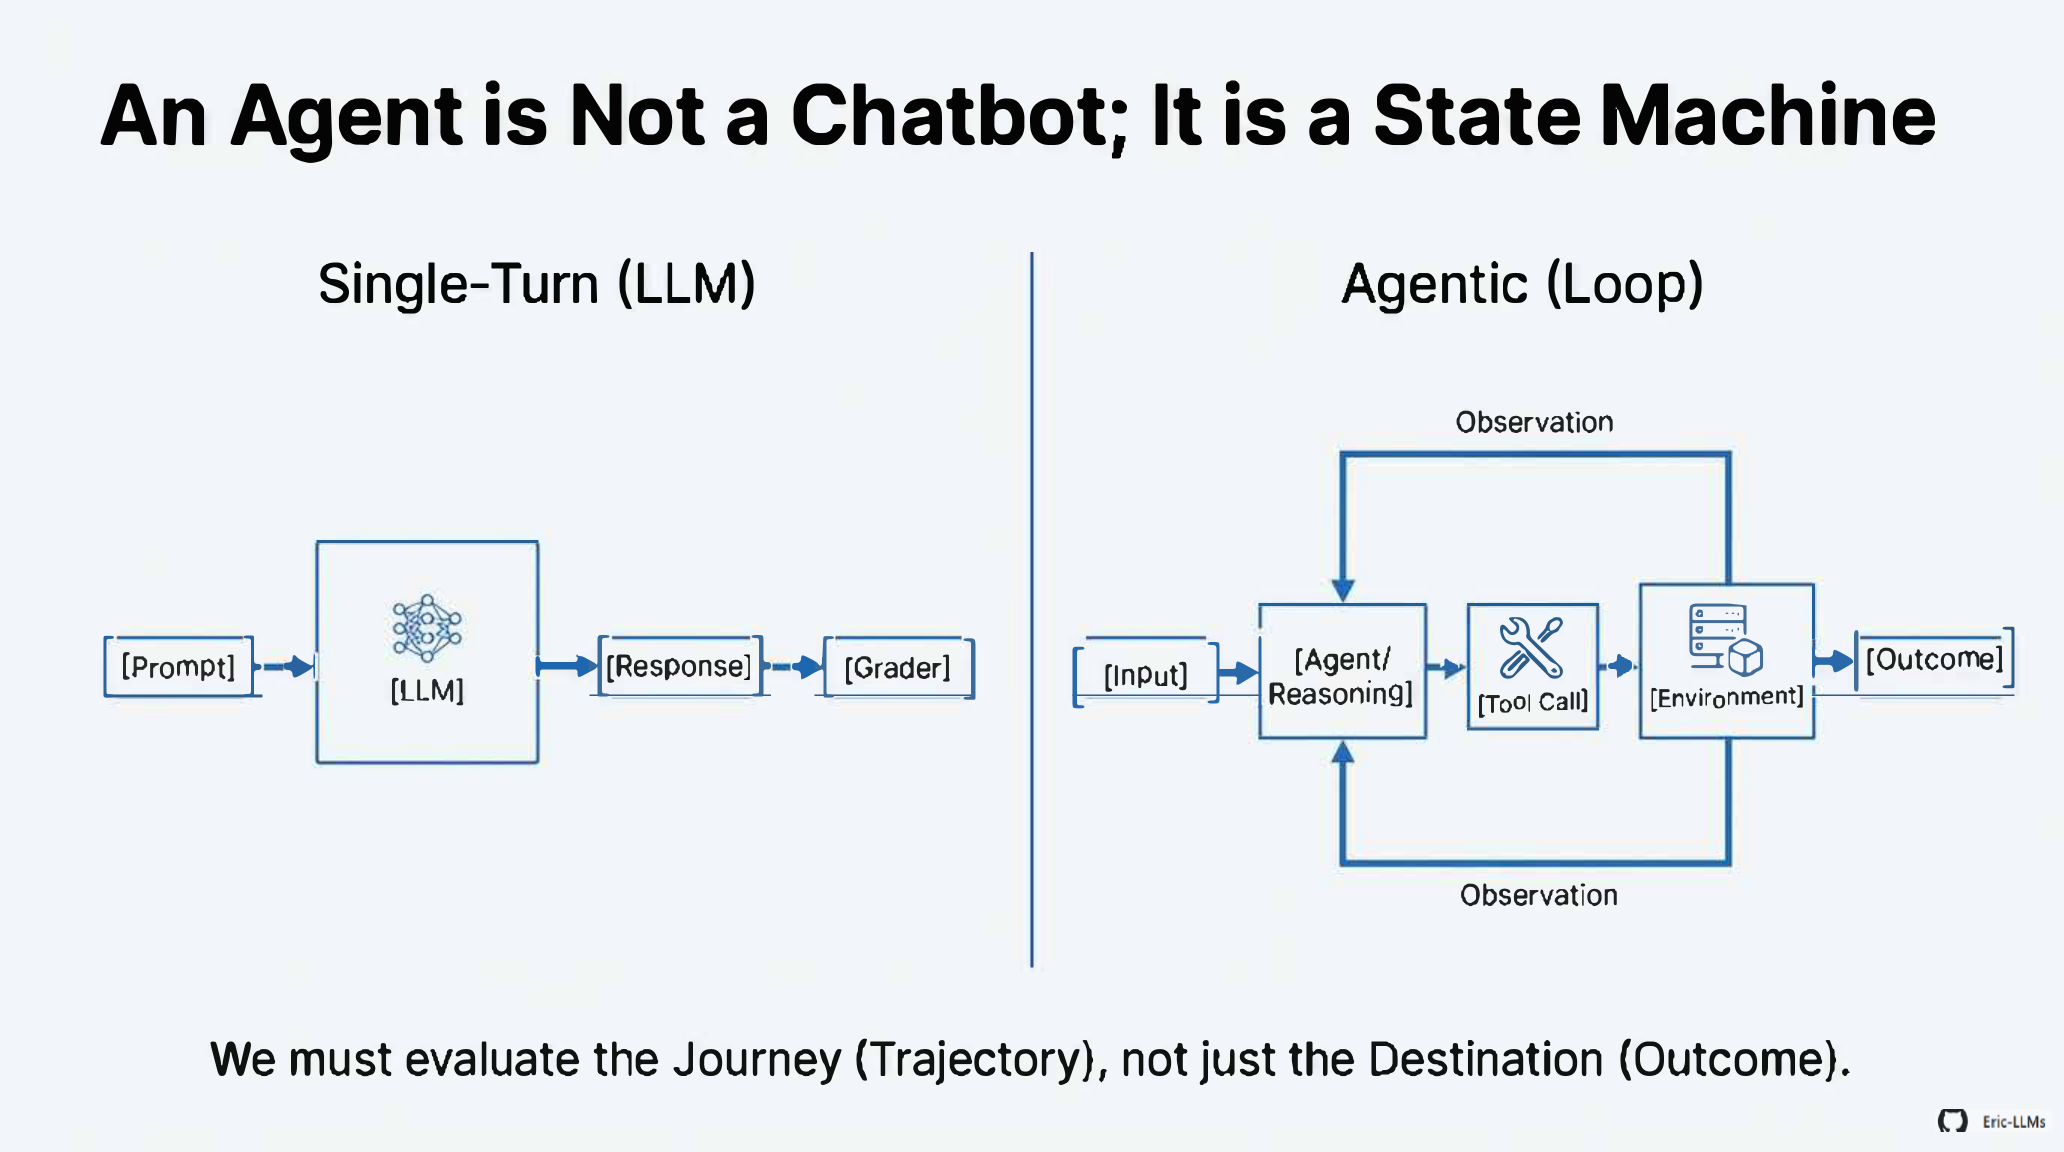
원문 캡처: Eric-LLMs, Agent Evaluation Engineering, 3쪽. 고정 판본 PDF, CC BY 4.0. PDF 한 쪽을 내용 변경 없이 PNG로 변환했다. 이미지를 누르면 크게 볼 수 있다.
왼쪽은 응답 뒤에 평가자를 붙인 흐름이고, 오른쪽은 도구를 사용해 바뀐 환경을 다시 관찰하는 루프다. 오른쪽 흐름에서는 마지막 문장만 읽으면 도구가 만든 효과를 놓친다. 그림의 ‘reasoning’ 표기를 모델의 숨은 사고 과정 전체에 접근할 수 있다는 뜻으로 읽지는 않는다.
파일을 저장했다는 답과 저장된 파일은 다르다
에이전트의 실행에는 최종 답변, 도구 호출 과정, 실행 뒤 환경이라는 서로 다른 관찰 대상이 있다. “파일을 저장했다”는 문장만 검사하면 실제 파일이 없어도 통과한다. 저장 함수를 호출했는지까지 보더라도 함수가 실패했거나 엉뚱한 내용을 썼을 수 있다. 파일 존재와 내용이 성공 조건이라면 실행 뒤 그 파일을 직접 읽어야 한다. 앞의 평가 그림이 구분하는 세 대상은 이렇게 서로 다른 오류를 드러낸다.
반대로 정해 둔 함수 이름을 사용했는지만 검사하면 같은 결과를 내는 유효한 구현을 실패로 판정할 수 있다. 평가하려는 요구사항을 실제로 관찰할 수 있는지부터 확인할 이유다.
반복 실행을 평가하는 pass@k와 pass^k도 비슷해 보여도 다른 질문이다. 전자는 여러 번 시도해 적어도 한 번 성공할 가능성, 후자는 정해진 여러 시도가 모두 성공할 가능성을 나타낸다.
서로 독립이고 성공 확률이 일정하게 0.7인 설명용 가정에서 세 번 시도하면 각각 1 − (1 − 0.7)^3 = 0.973, 0.7^3 = 0.343이다. 이는 저장소의 성능 측정값이 아니라 두 질문의 차이를 보이는 계산이다.
후보 중 정답 하나를 골라 쓰는 작업이라면 앞의 확률이 유용하다. 매번 제대로 처리해야 하는 자동화라면 뒤의 확률이 더 절실하다. 같은 성공 지표를 쓸 수 없는 작업들이다.
실제 시도는 같은 버그나 환경 상태를 공유할 수 있으므로 위 독립 가정을 그대로 쓰면 안 된다. 반복 실험에서는 실행 환경의 초기 상태도 맞춰야 한다. 이전 실행이 만든 파일 때문에 다음 실행이 성공하면 반복 성공률을 잘못 해석한다. 한편 모든 테스트에 컨테이너를 새로 띄우는 것만이 답은 아니다. 어떤 상태가 결과에 영향을 주는지 먼저 확인하고 그 상태를 통제해야 한다. 초기화 방법도 잡으려는 실패에 맞춰 고르면 된다.
기억 갱신을 뒤로 미루면 다음 요청은 무엇을 읽을까
사용자가 “앞으로 영어로 답해 줘”라고 말했다고 하자. 에이전트는 알겠다고 답하고, 선호 언어를 저장하는 일은 비동기 작업에 맡긴다. 사용자가 곧바로 다음 질문을 보내면 어떻게 될까? 저장 작업이 아직 끝나지 않았다면 검색기는 이전의 한국어 선호를 돌려줄 수 있다. 요청을 받았다는 사실과 새 기억을 읽을 수 있다는 사실 사이에 간격이 생긴다.
메모리 자료의 아래 그림은 이 간격이 생기는 두 실행 경로를 보여 준다. 위쪽은 응답 중 세션 상태를 읽고 쓰는 경로이고, 아래쪽은 대화에서 사실·선호·요약을 추출해 나중에 저장하는 경로다.
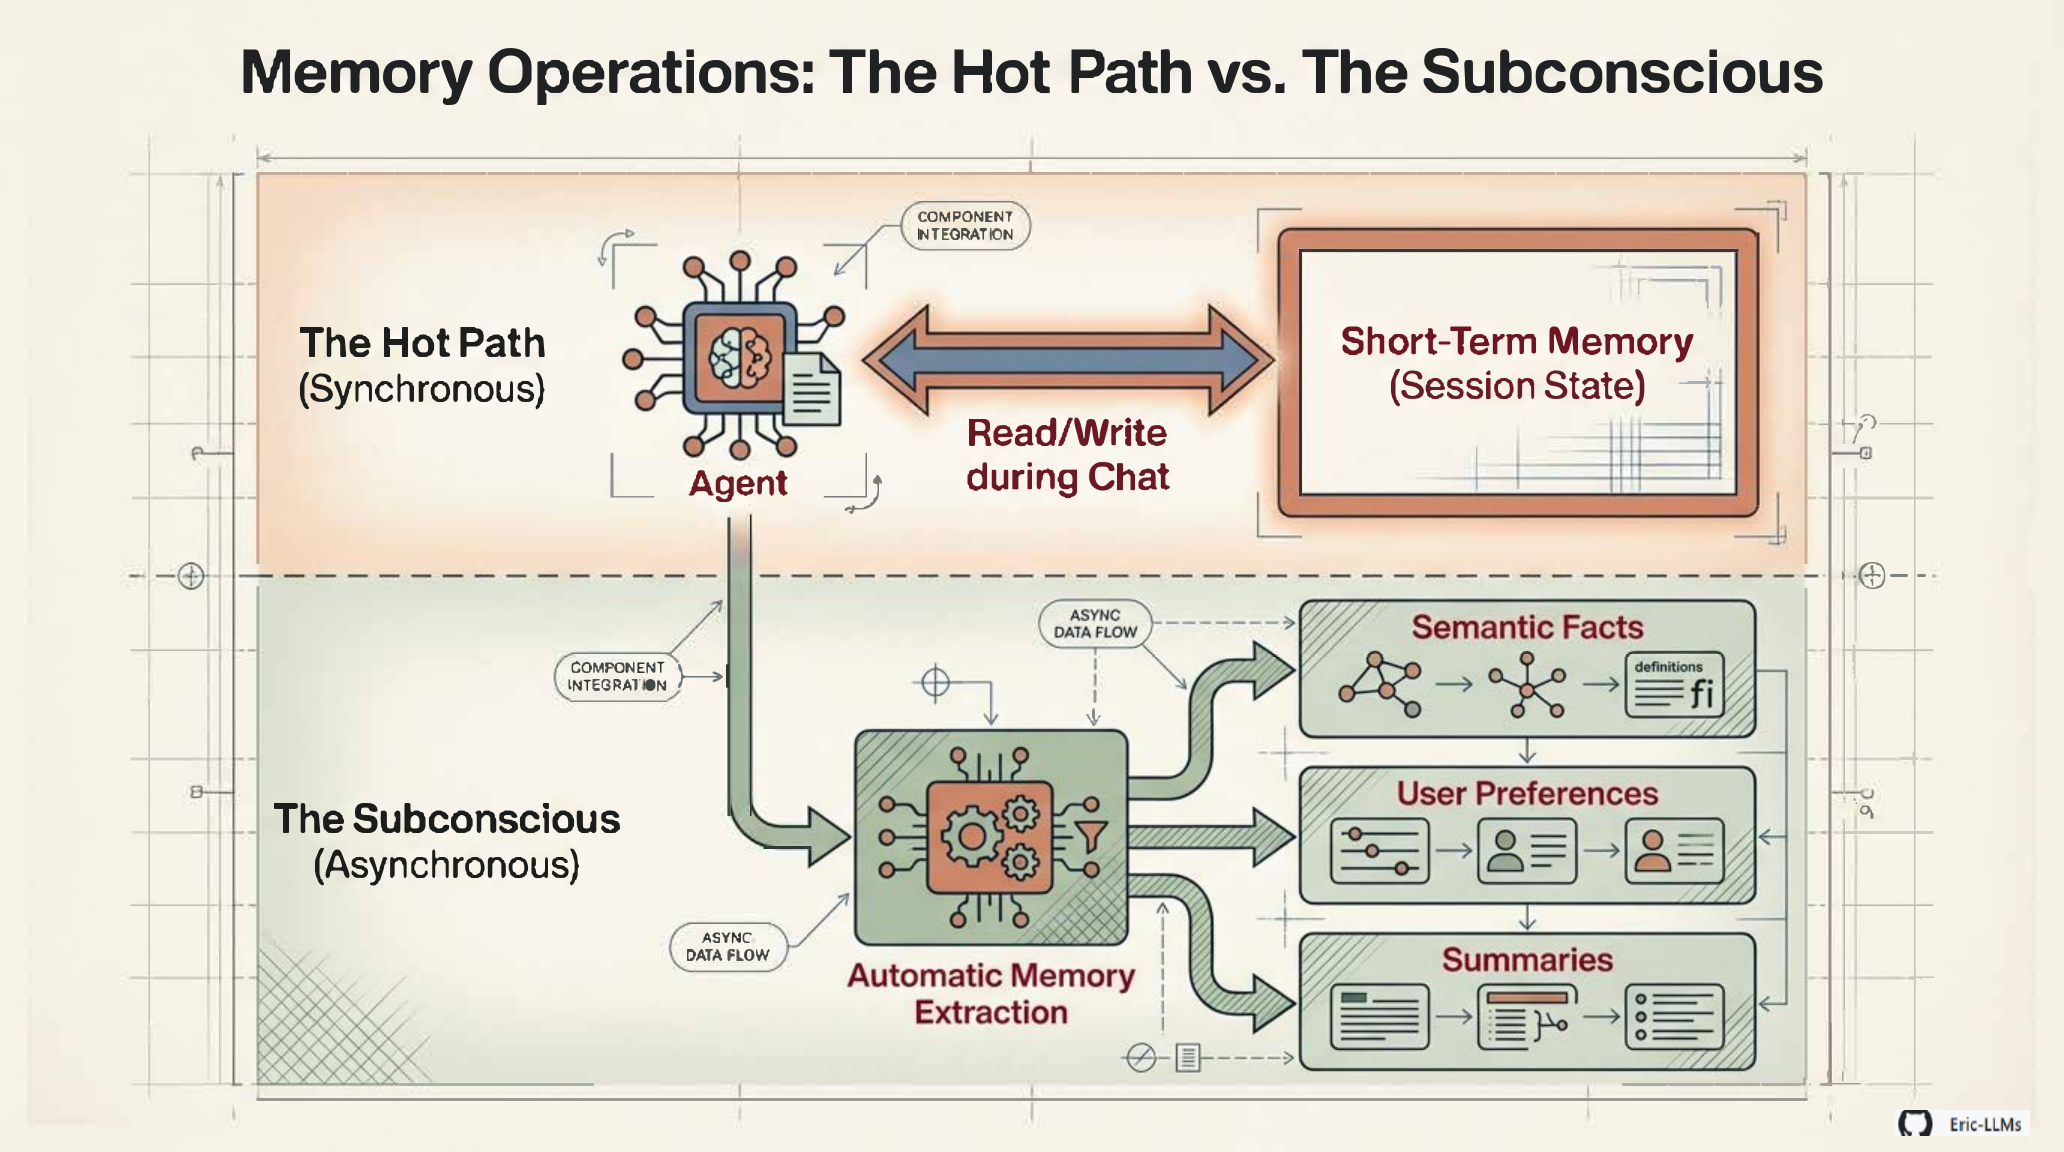
Eric-LLMs, Building Memory for Agentic AI: Theory, Frameworks, and Practice, 6쪽. 고정 판본 PDF, CC BY 4.0. 한 쪽을 내용 변경 없이 PNG로 변환했다. 누르면 확대할 수 있다.
추출과 색인 작업을 응답 밖으로 옮기면 사용자가 그 작업을 기다리지 않아도 된다. 다만 그림에는 “다음 요청이 반드시 갱신된 기억을 읽는다”는 보장이 없다. 이를 만들려면 어디에 저장한 값을 현재 사실로 인정할지 정해야 한다.
언어 설정처럼 키 하나로 찾을 수 있는 값은 유사도 검색을 거칠 필요가 없다. 사용자별 현재 설정을 먼저 갱신하고, 대화에서 추출한 검색용 기억은 그 설정을 덮어쓰지 못하게 만들 수 있다. 아래는 이 선택을 설명하는 가상 설계다. revision은 한 사용자의 언어 설정이 명시적으로 바뀔 때 증가하는 버전 번호이며, 원문 프로젝트의 구현을 재현한 것은 아니다.
| 시점 | 현재 설정 | 검색용 기억 | 답변 언어 |
|---|---|---|---|
| 변경 전 | 한국어, 버전 7 | 한국어, 버전 7 | 한국어 |
| 설정 저장 완료 | 영어, 버전 8 | 한국어, 버전 7 | 영어 |
| 다음 질문 도착 | 영어, 버전 8 | 버전 7 검색됨 | 영어 |
| 색인 반영 완료 | 영어, 버전 8 | 영어, 버전 8 | 영어 |
이 순서에서는 “설정을 바꿨다”는 답을 현재 설정의 저장 완료 뒤에 보낸다. 검색용 기억이 늦게 갱신되더라도 언어 선택은 흔들리지 않는다. 반대로 검색 색인만 읽는 구조라면 색인 반영까지 기다리거나, 반영 전에는 옛 값이 사용될 수 있다는 동작을 받아들여야 한다. 세 방식은 응답 시간과 일관성에서 서로 다른 비용을 낸다. 벡터 검색의 유사도 정확도를 높이는 것으로 이 시간차를 없앨 수는 없다.
작업의 완료 순서도 바뀔 수 있다. 버전 8을 색인에 쓴 뒤 느린 버전 7 작업이 끝나면 옛 값이 되살아날 수 있다. 따라서 쓰기 단계에서도 현재 버전보다 뒤처지지 않은 경우에만 반영하도록 조건을 건다. 버전 확인과 반영이 한 원자적 동작이어야 한다. 확인 뒤 쓰기 전에 다른 작업이 끼어들 수 있으면 같은 역전이 다시 생긴다. 조회할 때의 필터와 저장할 때의 조건이 함께 필요하다.
최신 기록이라고 더 믿을 만한 것은 아니다
시간 순서만 정해도 부족한 경우가 있다. 사용자가 직접 “영어로 답해 줘”라고 지정한 뒤 한국어로 질문했다고 하자. 추출 모델은 그 질문을 보고 “한국어를 선호한다”고 추측할 수 있다. 추측이 더 최근이라는 이유로 명시적 설정을 덮으면 기억을 갱신할수록 틀린 답을 하게 된다.
이 경우 두 기록은 출처와 의미가 다르다. 하나는 사용자가 지정한 설정이고, 다른 하나는 문장에서 추정한 선호다. 현재 설정에는 사용자의 명시적 변경을 반영하고, 추정값에는 추정이라는 출처를 남겨 별도로 취급해야 한다. 날짜만 비교하는 규칙으로는 이 차이를 표현할 수 없다.
저장할 대상에 따라 읽는 방법도 달라진다. 다음 표는 자료에 나온 제품의 성능 순위가 아니라, 위 사례에서 도출한 저장·조회 기준이다.
| 기억의 종류 | 저장할 근거 | 답변을 만들 때 읽는 방법 |
|---|---|---|
| 현재 선호·설정 | 사용자, 설정 키, 명시적 값, 버전 | 키로 최신 값을 읽는다. 검색된 옛 선호가 덮어쓰지 못하게 한다. |
| 대화 요약 | 요약의 원본 대화 범위와 버전 | 필요한 대화 맥락을 복원한다. 원본이 정정되면 이전 요약도 다시 만든다. |
| 과거 경험·사례 | 원본 식별자, 내용, 유효 상태 | 유사한 사례를 찾되 삭제되거나 효력이 끝난 원본의 결과는 제외한다. |
검색은 “이번 질문과 무엇이 비슷한가”에 답한다. 현재 상태의 조회는 “지금 무엇을 적용해야 하는가”에 답한다. 둘을 같은 벡터 검색 한 번으로 처리하면 비슷하지만 이미 폐기된 기록을 가져올 수 있다.
삭제도 같은 문제를 가진다. 원본을 지운 뒤 그 내용을 포함한 요약과 검색 색인이 남아 있으면, 다음 답변에는 삭제한 정보가 다시 나타난다. 처리 중이던 추출 작업이 삭제 후에 완료되어 색인을 다시 만드는 경우도 있다.
이를 막는 한 방법은 원본 식별자에 삭제 상태와 버전을 먼저 남기고, 조회와 비동기 쓰기에서 그 상태를 확인하는 것이다. 이후 원본·요약·색인·캐시의 복사본을 지운다. 외부 색인의 쓰기와 삭제 상태 확인을 하나로 묶을 수 없다면, 이미 실행 중인 옛 작업의 종료를 확인한 뒤 삭제를 다시 수행해야 한다. 그동안 조회에서는 삭제 상태를 계속 적용한다. 이 순서는 살아 있는 서비스에서 정보가 다시 노출되는 경로를 줄이지만, 백업까지 제거되었다는 증명은 아니다. 백업의 보관·삭제 절차는 별도로 맞춰야 한다. 메모리 자료의 갱신·망각 논의도 이렇게 읽으면 단순한 “벡터 삭제”가 실제 서비스의 어느 부분을 해결하는지 구별할 수 있다. 메모리 자료 14쪽
이 설계에서 기억 저장소를 바꾸더라도 남는 질문은 같다. 무엇을 현재 사실로 인정하고, 어느 시점부터 읽게 하며, 언제 더는 쓰지 못하게 할 것인가. 용량과 검색 속도는 이 동작을 정한 다음 비교할 수 있다.
말과 실제 결과를 분리하는 작은 검사
자료의 평가 기준을 코드로 옮기면 무엇이 달라지는지 확인해 보았다. 실제 모델을 호출하는 대신 동작이 정해진 세 함수를 사용한다. 모두 saved라고 답하지만, 하나는 파일을 만들지 않고, 하나는 정확히 저장하며, 마지막 하나는 정답 파일과 함께 보호할 파일까지 바꾼다. 작업의 성공 조건은 정답 파일을 저장하면서 보호 파일을 유지하는 것이다.
평가 함수는 답변과 환경의 변화를 각각 검사한다. action은 임시 디렉터리를 받아 작업한 뒤 문자열을 반환하는 함수다.
from pathlib import Path
from tempfile import TemporaryDirectory

def evaluate(action):
    with TemporaryDirectory() as directory:
        root = Path(directory)
        protected = root / "protected.txt"
        protected.write_text("keep")
        reply = action(root)
        answer = root / "answer.txt"
        correct_output = answer.is_file() and answer.read_text() == "42\n"
        unchanged = protected.read_text() == "keep"
return reply == "saved", correct_output and unchangedanswer.txt만 검사하면 보호 파일을 망가뜨린 실행도 통과한다. 성공 조건에 금지된 변경을 함께 넣으면 세 동작의 차이가 드러난다.
전체 예제는 Python 3 표준 라이브러리만 사용한다. 각 사례를 임시 디렉터리에서 실행하고 종료 시 지운다. 외부 API, 모델, 실제 사용자 파일은 사용하지 않는다.
python3 agent_outcome_demo.py실행 결과에서 reply는 답변 문자열만 검사한 판정이고, outcome은 파일의 내용과 보호 조건까지 검사한 판정이다.
claim_only   reply=True outcome=False
correct      reply=True outcome=True
side_effect  reply=True outcome=False
synthetic p=0.7, k=3: any=0.973, all=0.343
문자열 검사는 세 경우 모두 성공으로 본다. 결과 검사는 파일을 만들지 않은 경우와 금지된 부작용을 구별한다. 이것은 특정 에이전트의 실패율 측정이 아니라 무엇을 관찰하느냐에 따라 같은 실행의 판정이 달라진다는 대조다. 보호할 파일 하나를 확인했다고 전체 권한 경계가 검증된 것도 아니다. 파일 전체 변경 목록, 네트워크 쓰기 등 실제 계약에 포함된 효과는 그 계약에 맞는 별도 관측이 필요하다.
이 예제에서 correct가 실행되기 전에 정답 파일이 이미 존재한다면, 아무 일도 하지 않는 함수도 파일 내용 검사만으로 통과할 수 있다. 그래서 사례마다 새 디렉터리와 같은 초기 상태를 만들었다. 결과 검사와 환경 초기화가 함께 있어야 실행의 효과를 잘못 귀속하는 일을 줄인다.
자료를 읽었다면 자신의 평가 하나를 골라 보자. 최종 문장, 실행 과정, 실제 결과 중 무엇을 확인하고 있는가? 무엇을 놓치는지 알면 다음에 보완할 대상도 정할 수 있다. 구조를 비교할 때는 에이전트 하네스 논문 리뷰, 관측 신호를 고를 때는 AI 관측성 논문 리뷰로 이어서 읽을 수 있다.