DenseOn with the LateOn — Raphaël Sourty 외 | 단일 벡터와 토큰별 검색의 차이
목차
검색 질의에 단서가 두 개 있다. 한 문서는 첫 단서만 두 번 말하고, 다른 문서는 두 단서를 각각 담았다. 문서마다 벡터를 하나만 남기면 두 문서가 같은 점수를 받을 수 있다. 단서별로 문서 안에서 가장 가까운 표현을 찾으면 순위가 갈린다. 이 작은 차이가 학습 때 보지 못한 언어로 검색기를 옮길 때도 남을까?
DPR과 ColBERT의 점수식부터 비교해 보자. 그다음 2026년 연구로 넘어가, 다국어 검색에서도 어떤 차이가 났는지 살펴본다.
- DPR: Vladimir Karpukhin 외, Dense Passage Retrieval for Open-Domain Question Answering. EMNLP 2020 논문이며 2020년 4월 arXiv v1 기준이다.
- ColBERT: Omar Khattab·Matei Zaharia, ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. SIGIR 2020 논문이며 2020년 6월 arXiv v2 기준이다.
- DenseOn with the LateOn: Raphaël Sourty·Antoine Chaffin·Paulo Roberto Moura Junior·Amélie Chatelain, DenseOn with the LateOn: Fully Open Dense and Late-Interaction Models for Multilingual, Long-Context, and Code Search. 2026년 7월 31일 arXiv v2 프리프린트 기준이다.
문서를 미리 계산하려면 무엇을 접어야 하나
DPR은 질문과 문서를 별도 인코더에 넣어 각각 벡터 하나로 바꾼다. 검색 점수는 두 벡터의 내적이다. 문서 벡터를 질문이 오기 전에 계산해 색인할 수 있고, 실제 질의 때는 질문 벡터와 가까운 문서를 찾는다. 원 논문은 2,100만 개 문서 조각을 이런 방식으로 색인했다. 질문과 문서를 함께 인코더에 넣는 방식보다 사전 계산이 쉬운 대신, 한 문서에 있던 여러 단서는 결국 하나의 표현으로 압축된다.
여러 단서를 압축한다는 설명은 점수식에 대한 해석이다. DPR 논문에서 모든 복합 질의가 실패했다는 결과가 나온 것은 아니다. DPR v1, §3.1–3.2, PDF 3–4쪽
ColBERT도 문서를 미리 인코딩한다. 다만 문서마다 벡터 하나가 아니라 토큰별 벡터 묶음을 저장한다. 질의 토큰 하나마다 문서 토큰 중 가장 비슷한 것을 고르고, 그 최댓값들을 더한다. 이것이 MaxSim이다. 원 논문은 문맥을 반영한 토큰 벡터를 정규화하므로 벡터 내적을 코사인 유사도로 읽을 수 있다. 토큰별 표현은 따로 계산하고 두 표현 사이의 비교만 나중에 수행한다. 그래서 late interaction이라는 이름이 붙었다. 문서 인코더를 질의마다 다시 돌릴 필요는 없지만, 저장할 벡터와 질의 시 비교할 토큰 쌍이 늘어난다. ColBERT v2, §3.1–3.3, PDF 4–5쪽
두 질의 토큰을 각각 (1, 0), (0, 1)이라는 길이 1의 벡터로 놓자. 첫 좌표와 둘째 좌표는 서로 다른 두 단서의 방향을 뜻한다. 문서 A의 토큰은 (1, 0), (0, 1)이고, 문서 B의 토큰은 (1, 0), (1, 0)이라고 하자. 질의와 문서를 각각 단순 평균한 뒤 내적하면 A와 B가 모두 0.5다. 하지만 토큰마다 최대 내적을 더하면 A는 1 + 1 = 2, B는 1 + 0 = 1이다. B가 첫 단서를 두 번 갖고 있어도 둘째 단서를 대신하지는 못한다.
두 단서를 평균으로 접으면 이 합성 예시에서는 동점이 된다. MaxSim은 질의의 각 단서가 문서에 대응하는지 따로 계산한다. 실제 모델의 성능 비교가 아니다.
q = [(1, 0), (0, 1)]
a = [(1, 0), (0, 1)]
b = [(1, 0), (1, 0)]

def dot(x, y):
    return sum(i * j for i, j in zip(x, y))

def mean(vectors):
    return tuple(sum(v[i] for v in vectors) / len(vectors) for i in range(2))

def maxsim(query, document):
    return sum(max(dot(token, candidate) for candidate in document) for token in query)

assert dot(mean(q), mean(a)) == dot(mean(q), mean(b)) == 0.5
assert (maxsim(q, a), maxsim(q, b)) == (2, 1)
이 코드는 외부 모델이나 검색 데이터 없이 점수식의 차이만 재현한다.
DPR과 2026년 DenseOn은 평균 대신 요약 토큰인 [CLS]의 학습된 표현을 쓰며, ColBERT의 실제 점수에는 문맥 인코딩·특수 토큰·토큰 필터링이 관여한다. 위 동점만으로 단일 벡터 검색기의 성능을 일반화할 수는 없다. 이 예제에서는 평균을 낼 때 사라지는 단서가 있고, MaxSim은 그 단서를 따로 비교한다는 차이를 보면 된다.
2026년 논문의 다국어 late-interaction 모델은 원래 ColBERT의 합 대신 질의 길이로 나눈 MeanMaxSim을 학습에 사용한다. 위 예시에서도 A와 B는 각각 1과 0.5로 갈린다. DPR v1, §3.1, PDF 3쪽 · ColBERT v2, §3.2–3.3, PDF 4–5쪽 · DenseOn/LateOn v2, §2.3.2·부록 C.2, PDF 5·14쪽
같은 재료로 학습해도 결과가 갈리는가
Sourty 등은 2026년 연구에서 기반 모델과 학습 자료를 맞춰 두 방식을 비교했다. 저자들은 영어 학습 쌍 약 14억 개에서 필터를 적용해 6억 6,500만 개를 골랐고, 여덟 언어로 번역한 자료와 교차 언어 쌍을 만들어 다국어 사전 학습 쌍 약 28억 개를 구성했다. 다국어 모델인 mDenseOn과 mLateOn은 같은 3억 700만 매개변수의 mmBERT-base 기반 모델, 학습 자료, 큰 훈련 목표를 공유한다. 전자는 문서 하나를 벡터 하나로, 후자는 토큰별 벡터로 검색한다.
단, 정확히 한 변수만 바꾼 실험은 아니다. 모델별 접두어와 풀링·점수 함수가 다르고, 단일 벡터 쪽에는 작은 차원의 출력을 위한 Matryoshka 학습이 적용된다. 결과를 볼 때는 각각의 학습 설정까지 포함한 두 모델을 비교했다는 점을 염두에 두자. DenseOn/LateOn v2, §2.1–2.3, PDF 3–5쪽
저자들이 보고한 MIRACL의 nDCG@10은 상위 10개 결과에서 관련 문서가 얼마나 앞에 놓였는지 평가하는 점수다. 같은 지표 안에서는 클수록 좋다. 논문 표 2의 값은 0–100 척도로 적혔다.
여기서 대상 언어 평균은 MIRACL의 18개 언어 중 검색 학습에 사용한 언어와 겹치는 5개(아랍어·영어·프랑스어·독일어·스페인어)만의 평균이다. 전체 평균은 18개를 모두 포함한다. DenseOn/LateOn v2, §3.2·표 2, PDF 6–7쪽
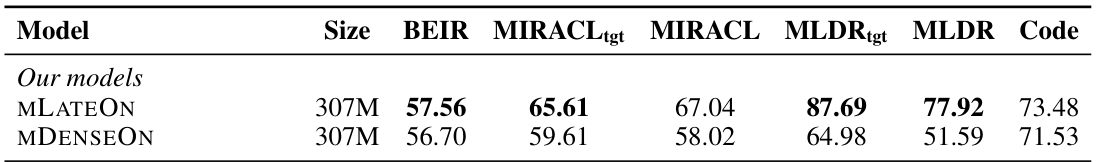
원문 부분 인용: Raphaël Sourty 외, DenseOn with the LateOn v2, PDF 6쪽 표 2. 열 머리글과 제안 모델 두 행만 발췌했고 다른 모델 행은 생략했다. 이미지를 누르면 크게 볼 수 있다.
원문은 mLateOn을 위에, mDenseOn을 아래에 놓았다. MIRACL_tgt는 대상 언어, MIRACL은 전체 언어 평균이다. 아래 표는 비교할 세 열을 골라 단일 벡터부터 읽도록 행 순서를 바꿨다.
| 모델 | MIRACL 대상 5개 언어 | MIRACL 전체 18개 언어 | MLDR 전체 13개 언어 |
|---|---|---|---|
| mDenseOn, 단일 벡터 | 59.61 | 58.02 | 51.59 |
| mLateOn, 토큰별 벡터 | 65.61 | 67.04 | 77.92 |
표의 nDCG@10은 저자들이 보고한 값이다. MIRACL 대상 언어에서 6.00점, 전체에서 9.02점의 차이가 난다. 검색 학습에 쓰지 않은 언어 중 핀란드어와 한국어를 따로 보면 다음과 같다. 원문 언어별 표에서 두 행을 옮기고 차이를 계산했다. 검색 학습에 없었다는 말은 기반 mmBERT의 사전 학습에서도 그 언어를 보지 않았다는 뜻이 아니다. DenseOn/LateOn v2, 표 2, PDF 6쪽 · 부록 B.3·표 5, PDF 13·17쪽
| 언어 | mDenseOn | mLateOn | 차이: mLateOn − mDenseOn |
|---|---|---|---|
| 핀란드어 | 52.5 | 74.3 | +21.8점 |
| 한국어 | 61.3 | 71.9 | +10.6점 |
두 언어 모두 토큰별 표현을 남긴 쪽의 점수가 높지만 차이는 두 배 가까이 다르다. 전체 평균만으로 특정 언어에서 얻을 개선 폭을 예상하기 어려운 이유다. 이 두 행만으로 모든 언어의 우열을 대표하지는 않는다.
그럼 점수가 오른 이유도 앞의 예시로 설명할 수 있을까? “두 단서를 따로 찾는다”는 원리는 원 논문의 점수식과 같다. 하지만 핀란드어와 한국어에서 정확히 어떤 토큰의 일치가 점수를 올렸는지 분석한 결과는 없다. 원문도 보지 못한 언어에서 late interaction이 mmBERT 사전 학습의 다국어 구조를 더 잘 보존했을 가능성으로 해석한다. 전체 평균 67.04가 대상 언어 평균 65.61보다 높다고 해서 모든 미학습 언어가 대상 언어보다 쉽거나 성능이 좋다는 뜻도 아니다. 두 평균의 언어 구성이 다르다.
저자들에 따르면 mLateOn도 인도네시아어와 스와힐리어에서는 상대적으로 약했다. DenseOn/LateOn v2, §3.2, PDF 7–8쪽 · 부록 표 5, PDF 17쪽
같은 원문 표 5에서 상대적으로 약한 두 언어를 함께 놓으면 차이가 보인다. 아래 값은 모두 MIRACL의 nDCG@10이며 0–100 척도다.
| 모델 | 인도네시아어 | 스와힐리어 |
|---|---|---|
| mDenseOn | 47.5 | 42.3 |
| mLateOn | 55.4 | 57.8 |
| BGE-M3 | 56.1 | 78.6 |
| pplx-embed-v1-late-0.6b | 57.4 | 75.7 |
mLateOn은 mDenseOn보다 높지만, 스와힐리어에서는 다른 비교 모델과 큰 차이가 남는다. 이 표는 서로 학습 조건이 다른 모델의 보고값을 함께 놓은 것이므로, 그 차이를 late interaction 하나의 인과 효과로 해석할 수는 없다. 원문 전체 모델 중 이 비교에 필요한 네 행을 골랐다.
점수 뒤에 남는 비용과 평가 조건
토큰별 벡터의 저장 공간과 질의 시간
DPR식 단일 벡터는 문서마다 하나를 저장한다. ColBERT식 표현은 문서 토큰 수만큼 벡터를 저장하고 질의 토큰별 비교 결과를 모은다. 2020년 ColBERT 원 논문에서도 MS MARCO 문서 집합을 표현하는 공간은 128차원·4바이트 설정에서 286 GiB, 24차원·2바이트 설정에서 27 GiB였고, 작은 설정의 MRR@10(상위 10개 안 첫 정답 순위의 역수 평균)은 34.9에서 33.9로 내려갔다.
| ColBERT 설정 | 문서 표현 공간 | MRR@10 |
|---|---|---|
| 128차원, 값당 4바이트 | 286 GiB | 34.9 |
| 24차원, 값당 2바이트 | 27 GiB | 33.9 |
Khattab·Zaharia, ColBERT (2020), arXiv 판본 v2의 표 4의 두 설정을 재구성했다. 차원과 정밀도를 함께 바꾼 비교이므로, 259 GiB 감소를 둘 중 하나만의 효과로 나눌 수는 없다.
이 수치는 당시 ColBERT의 설정별 저장·품질 교환관계다. 2026년 mLateOn의 공간 사용량이나 실제 응답 시간을 뜻하지 않는다. Sourty 등의 논문에는 mDenseOn과 mLateOn의 배포 색인 크기·지연 시간 비교가 없다. ColBERT (2020), arXiv v2, §4.5·표 4, PDF 9쪽 · DenseOn/LateOn v2, §3·한계, PDF 5–9쪽
번역 자료와 실제 사용자 질문의 차이
저자들은 영어 학습 쌍을 기계 번역할 때 질의와 정답 문서를 함께 번역했다. 이 방식은 둘 사이에 비슷한 표현을 남겨 실제 사용자의 질문보다 양성 쌍을 쉽게 만들 수 있다.
다국어 세밀 조정에 MIRACL·MLDR의 자연 발생 자료를 더했지만, 사전 학습의 대부분은 번역 자료다.
번역 품질을 사람이 언어별로 검토하거나 도메인별 오류를 분석하지 않았고, 다른 기반 모델·규모·배포 환경으로 같은 결과가 옮겨지는지도 확인하지 않았다. MLDR에서는 대상 언어의 학습 분할을 세밀 조정에 사용했으므로, 그 자료 사용 여부가 분명하지 않은 외부 모델과의 순위 비교는 특히 조심해야 한다. DenseOn/LateOn v2, §2.2·§3.2·한계, PDF 3–4·7–9쪽
자체 질의로 선택 기준을 확인한다
“late interaction을 항상 쓰자”로 결론 내리기 전에, 보지 못한 언어와 긴 문서에서 관련 단서를 얼마나 놓치는지 자체 검색기로 확인해 보자. 자체 질의를 언어별·문서 길이별로 나누고, 같은 문서 집합과 정답 표지에서 한 벡터와 토큰별 벡터의 nDCG@10 또는 정답 포함률을 비교한다.
그 뒤 색인 크기와 응답 시간을 함께 잰다. 짧은 문서와 한 가지 언어에서 단일 벡터가 필요한 품질을 내고 저장·지연 예산이 빡빡하다면 더 큰 토큰별 색인을 선택할 근거가 없다. 반대로 빠진 두 번째 단서가 순위를 자주 뒤집는다면, 위 합성 예시가 보여 준 차이를 실제 질의의 어느 토큰에서 찾을지 조사하면 된다. 여기까지는 세 논문을 읽고 제안하는 도입 전 확인 방법이다. 2026년 논문에는 이를 대신할 배포 벤치마크가 없다.