FlashAttention·FA4·FP4 — Tri Dao 외, Ted Zadouri 외, Robert Hu의 최적화 연구
목차
행렬곱이 네 배 빨라지면 attention도 네 배 빨라질까? 2026년 9월의 FP4 연구에서는 그렇게 되지 않는 이유를 살펴본다. 점수와 출력을 만드는 행렬곱을 4비트 부동소수점(FP4)으로 계산해도, 그 사이에서 점수를 softmax 확률로 바꾸고 다음 행렬곱이 읽을 수 있게 만드는 시간이 남는다. 게다가 커널 하나가 빨라졌다고 모델 학습이 같은 비율로 빨라지거나, 낮은 정밀도가 긴 학습에서 안정적이라는 뜻도 아니다. FP4 논문 v1, 1–2쪽·5–6쪽 같은 논문, 10쪽 표 6
어떤 비용을 줄였고 그 뒤에는 무엇이 남았는지, 세 연구를 차례로 따라가 보자. 전체 저자와 판본은 글 끝의 ‘참고 논문’에 적었다.
| 읽을 연구 | 저자·공개 시점 | 풀려는 병목 |
|---|---|---|
| FlashAttention | Tri Dao 외, 2022년 5월 | 정확한 attention을 유지하며 GPU 메모리 왕복 줄이기 |
| FlashAttention-4(FA4) | Ted Zadouri 외, 2026년 3월 | Blackwell의 행렬곱 이외 작업과 온칩 메모리 사용 |
| Hardware-Aware FP4 FlashAttention-4 | Robert Hu, 2026년 9월 | FP4 확률 생성 경로와 학습용 정밀도 |
세 번째 논문은 별도 저자의 후속 기술 보고서다. FA4 원저자들의 연구와는 실험 조건이 다르므로 성능 수치도 나눠 읽어야 한다. 아래 성능·품질 수치는 직접 GPU로 재현한 값이 아닌 각 논문의 보고값이다.
첫 번째 비용: N × N을 계산하는 것과 저장하는 것은 다르다
한 attention head에서 N은 토큰 수, d는 head 차원이다. 쿼리 Q, 키 K, 값 V는 각각 N × d 행렬이고, 보통 S = QKᵀ/√d, P = softmax(S), O = PV로 출력을 구한다. Softmax는 S의 각 행에 적용된다. HBM(High Bandwidth Memory)은 GPU 칩 밖에 있는 대용량 메모리다. 용량이 큰 대신 칩 안의 작업 공간과 데이터를 주고받는 비용이 든다. 평범하게 세 연산을 별도 커널로 실행하면 S와 P가 각각 N × N 크기로 HBM에 기록되고 다시 읽힌다.
예를 들어 한 head에서 N=4096이면 중간 행렬 한 장이 약 1,678만 원소다. 원소가 2바이트라고 가정할 때 행렬 한 장에만 32 MiB가 든다. MiB는 2²⁰바이트다. 이 크기는 설명을 위한 산술값이며 특정 GPU에서 측정한 메모리 사용량이 아니다. FlashAttention v1, 4쪽 §2.2·Algorithm 0
FlashAttention은 입력을 작은 블록으로 가져와 더 작고 빠른 온칩 메모리인 SRAM에서 점수, softmax, 출력의 일부를 이어 계산한다. 전체 S와 P를 HBM에 만들지 않는다.
역전파에 필요한 중간 행렬도 전부 저장하는 대신 블록별로 재계산한다. 그래서 **정확한 dense attention의 산술량은 여전히 O(N²d)**이지만, 입력·출력을 제외한 추가 메모리는 논문의 알고리즘에서 O(N)이고, 비싼 HBM 접근은 줄어든다.
논문의 exact는 토큰 쌍을 근사적으로 생략하지 않고 같은 attention 식을 계산한다는 뜻이다. 유한 정밀도 연산에서 다른 커널과 비트 단위로 같은 결과를 보장한다는 말은 아니다. FlashAttention v1, 4–6쪽 §3.1–3.2·정리 1–2
블록을 어떻게 읽는지 보면 HBM 접근이 줄어드는 이유도 알 수 있다. 원래 구현은 점수와 확률의 모든 N² 원소를 HBM에 내보낸다. FlashAttention은 SRAM에 들어갈 만큼의 K,V 블록을 잡고 Q 블록을 순회한다. 이때 Q와 출력 일부를 다시 읽고 쓸 수는 있지만, N × N 중간 행렬의 왕복을 없앤다.
논문은 SRAM 크기를 원소 수 M으로 놓고 d ≤ M ≤ Nd인 범위에서 표준 구현의 접근량을 Θ(Nd + N²), 제시한 방식의 접근량을 Θ(N²d²/M)으로 분석한다. Θ는 상수 배수를 제외했을 때 입력 크기에 따라 증가하는 정도를 나타낸다. 따라서 M, d, 실제 블록 크기에 따라 이득이 달라지며, 블록을 무한정 키울 수도 없다. 저자들의 A100 실험에서도 블록이 커질수록 HBM 접근과 실행 시간이 줄었다. 하지만 다른 연산 비용과 SRAM 용량 때문에 계속 같은 이득을 얻지는 못했다. FlashAttention v1, 6쪽 정리 2·그림 2
같은 그림의 왼쪽 비교는 계산량과 메모리 접근량을 나란히 보여 준다.
| A100의 attention 전방·역방향 | 계산량 | HBM 읽기·쓰기 | 실행 시간 |
|---|---|---|---|
| 표준 구현 | 66.6 GFLOPs | 40.3 GB | 41.7 ms |
| FlashAttention | 75.2 GFLOPs | 4.4 GB | 7.3 ms |
FlashAttention v1, PDF 6쪽 그림 2의 왼쪽 표를 재구성했다. GPT-2 medium, 시퀀스 길이 1024, head 차원 64, head 16개, 배치 64 조건이다. GFLOPs는 이 실행의 부동소수점 연산 수를 10억 단위로 센 값이며 초당 처리량이 아니다.
재계산 때문에 연산 수는 늘었지만 HBM 왕복이 크게 줄어 실행 시간은 짧아졌다. “연산을 덜 해야 빨라진다”는 생각만으로는 설명할 수 없는 결과다. 오른쪽의 희소 attention 실험은 일부 토큰 쌍을 생략하는 별도 설정이므로 이 두 행에 섞지 않았다.
온라인 softmax가 블록 사이의 값을 어떻게 이어 주나
문제는 softmax의 분모다. 한 쿼리 행의 점수들이 여러 키 블록에 흩어져 있는데, 첫 블록을 읽을 때는 뒤에 더 큰 점수가 나올지 모른다. 다음 세 값만 유지하면 전체 확률 행을 저장하지 않고도 결과를 합칠 수 있다.
m: 지금까지 본 점수의 최댓값ℓ:m을 뺀 점수들의 지수 합, 곧Σ exp(sⱼ − m)u: 같은 가중치로 값vⱼ를 더한, 아직 나누지 않은 출력Σ exp(sⱼ − m)vⱼ
여기서 j는 원소 번호, sⱼ는 그 원소의 점수, vⱼ는 대응하는 값이다. Σ는 합, exp(x)는 지수 함수 eˣ를 뜻한다. 새 블록을 읽을 때는 다음처럼 갱신한다. 오른쪽 합은 새 블록의 원소에만 적용한다.
m′ = max(m, 새 블록의 최댓값)
ℓ′ = exp(m − m′) × ℓ + Σ exp(sⱼ − m′)
u′ = exp(m − m′) × u + Σ exp(sⱼ − m′) × vⱼ
최종 출력은 u′/ℓ′이다. 새 최댓값 때문에 과거 합의 기준이 바뀌었을 때 exp(m − m′)를 곱하는 것이 핵심이다. 이 배율을 빠뜨리면 블록 경계에 따라 결과가 바뀐다. FlashAttention v1, 4–5쪽 §3.1·Algorithm 1
그림은 아래의 자체 산술 예제를 그린 것이다. 새 최댓값에 맞춰 과거 분자와 분모를 같은 배율로 줄여야 블록 경계가 바뀌어도 결과가 같다.
작은 예로 확인해 보자. ln은 자연로그다. 이미 1/√d로 조정된 한 쿼리의 점수가 [0, ln 2, ln 4], 대응하는 스칼라 값이 [10, 20, 40]이라고 하자. 첫 블록에 앞의 두 원소가 있다면 m=ln 2, ℓ=1/2+1=1.5, u=(1/2)·10+1·20=25다.
다음 블록에서 ln 4가 나타나면 새 최대는 ln 4이고 과거 합에는 exp(ln 2−ln 4)=1/2를 곱한다. 따라서 ℓ′=0.5·1.5+1=1.75, u′=0.5·25+40=52.5, 출력은 52.5/1.75=30이다. 처음부터 계산해도 가중치가 1:2:4이므로 (1·10+2·20+4·40)/7=30이다. 이는 원리를 확인하려고 따로 만든 산술 예시다. 논문의 GPU 벤치마크 결과는 아니다.
표준 라이브러리만 쓰는 실행 예제를 python3 online_softmax_demo.py로 실행하면 같은 결과를 확인할 수 있다. 블록 크기를 바꿔도 출력은 30으로 유지되며, 과거 합의 배율 조정을 생략한 대조 구현은 26을 낸다. 큰 점수에서도 전체 계산과 블록별 계산이 허용 오차 안에서 같은지 검사한다.
2022년 논문에는 실제 모델 학습 결과도 있다. 같은 초기값에서 목표 masked-language-modeling 정확도에 도달하는 BERT-large 실험은 8×A100에서 기존 NVIDIA MLPerf 1.1 구현 20.0±1.5분, FlashAttention 구현 17.4±1.4분으로 보고됐다. GPT-2 실험은 별도 구현·데이터·학습 일정이므로 이 수치를 현재 모델이나 다른 GPU의 보편적인 속도 배율로 옮기면 안 된다. 논문 자체도 구현마다 새 CUDA 커널이 필요하고 GPU 구조가 바뀌면 코드를 옮기기 어렵다는 한계를 적었다. FlashAttention v1, 7쪽 표 1 10쪽 §5
| BERT-large 학습 구현 | 목표 정확도까지 걸린 시간 |
|---|---|
| NVIDIA MLPerf 1.1 기준 구현 | 20.0 ± 1.5분 |
| FlashAttention 적용 | 17.4 ± 1.4분 |
FlashAttention v1 표 1 중 BERT-large의 두 행만 재구성했다. GPU는 8×A100이며, GPT-2의 결과나 커널 단독 측정과 섞지 않는다.
HBM을 아낀 뒤에는 무엇이 기다리는가
FA4의 출발점은 Blackwell에서 행렬곱 처리량이 더 빨리 증가했다는 관찰이다. 논문은 B200에서 16비트 부동소수점의 한 형식인 BF16 행렬곱 처리량이 H100의 약 두 배가 됐지만, 연산 묶음 하나당 지수 함수 처리량과 공유 메모리 읽기 대역폭은 같은 수준이라고 설명한다. GPU의 행렬 연산 전용 장치인 tensor core만 더 빨라진 셈이다.
따라서 QKᵀ와 PV만 빨라지면 softmax의 지수 계산과 온칩 공유 메모리 읽기가 상대적으로 도드라진다. HBM 왕복을 줄이고 나니 다른 작업이 전체 시간을 결정한다. 논문의 하드웨어 수치와 단순화한 처리량 분석에서 나온 설명이므로, attention 모양이 달라도 항상 같은 유닛에서 막힌다고 볼 수는 없다. FA4 v1, 2–5쪽 §2.2·§3.1.1
FA4는 Blackwell의 비동기 행렬곱 결과가 저장되는 tensor memory(TMEM)를 활용해, 두 쿼리 타일 중 한쪽이 행렬곱을 하는 동안 다른 쪽이 softmax를 진행하도록 파이프라인을 짠다. 전방에서는 일부 지수 계산을 다항식과 곱셈·덧셈 결합 연산으로 옮기고, 온라인 최대값이 조금 올랐을 때는 매번 출력을 다시 배율 조정하지 않도록 한다. 다항식은 수학적 지수 함수의 근사다. 따라서 2022년 논문의 정확한 dense attention 알고리즘이라는 표현을 FA4의 모든 부동소수점 중간값이 엄밀히 같다는 의미로 넓히면 안 된다.
FA4 논문은 400만 난수 입력에서 다항식의 FP32 오차와 BF16 반올림 후 오차를 따로 제시한다. 역방향에서는 TMEM과 두 스레드 묶음(CTA)이 함께 행렬곱하는 방식을 써 공유 메모리 통행량과 쿼리의 기울기 dQ를 여러 작업이 안전하게 더하는 비용을 줄인다. FA4 v1, 6–9쪽 §3.1·표 2 11–12쪽 표 3·§3.2.3
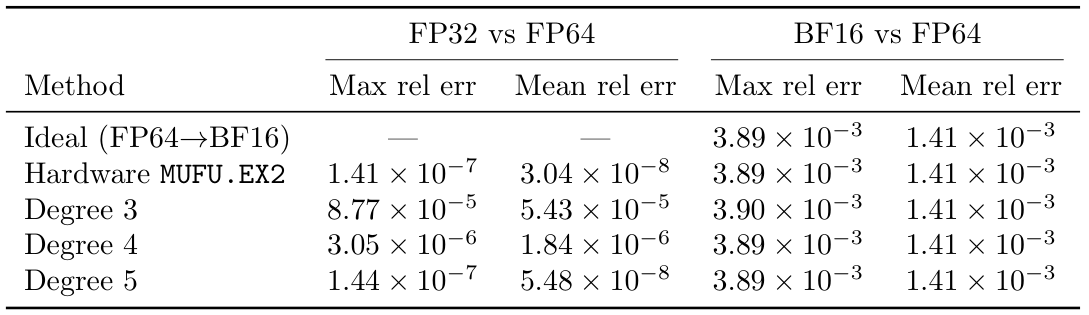
Ted Zadouri 외, FlashAttention-4 v1, PDF 8쪽 표 2, CC BY-NC-SA 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
표의 왼쪽 두 열은 FP32 계산 결과를, 오른쪽 두 열은 그 값을 BF16으로 반올림한 결과를 FP64 기준과 비교한다. 예를 들어 3차 다항식의 최대 상대 오차는 FP32에서 8.77×10⁻⁵, BF16 반올림 뒤에는 3.90×10⁻³다. 5차로 높이면 FP32 오차는 1.44×10⁻⁷까지 줄지만 BF16 오차는 3.89×10⁻³로 거의 같다. BF16으로 사용할 값이라면 다항식 차수를 계속 올려도 최종 오차 이득이 작다는 근거다.
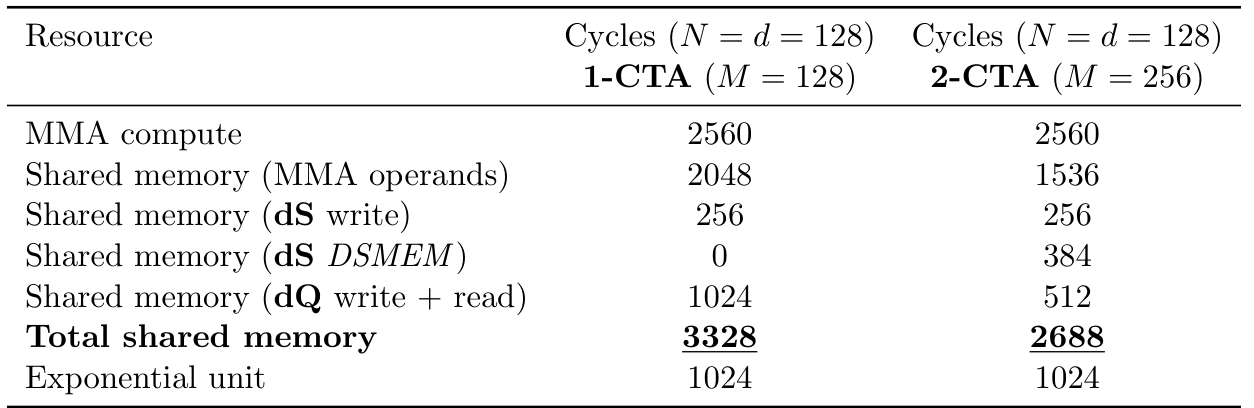
Ted Zadouri 외, FlashAttention-4 v1, PDF 11쪽 표 3, CC BY-NC-SA 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
이 표는 실제 전체 커널 지연을 잰 표가 아니라, 타일 설정별 자원 처리량으로 계산한 사이클 비교다. 1-CTA에서 행렬곱은 2,560사이클인데 공유 메모리는 3,328사이클이다. 2-CTA 설정에서는 공유 메모리 비용이 2,688사이클로 줄어 행렬곱과 가까워진다. 연산 장치가 빨라도 데이터를 공급하는 쪽이 더 오래 걸리면 그 장치를 기다리게 한다.
성능 결과의 측정 단위는 attention 커널이다. 논문은 B200, BF16, 여러 시퀀스 길이·head 크기에서 전방 커널이 cuDNN 9.13보다 최대 1.3배, Triton보다 최대 2.7배 빠르고 최대 1613 TFLOP/s(초당 1,613조 회의 부동소수점 연산)에 도달했다고 보고한다.
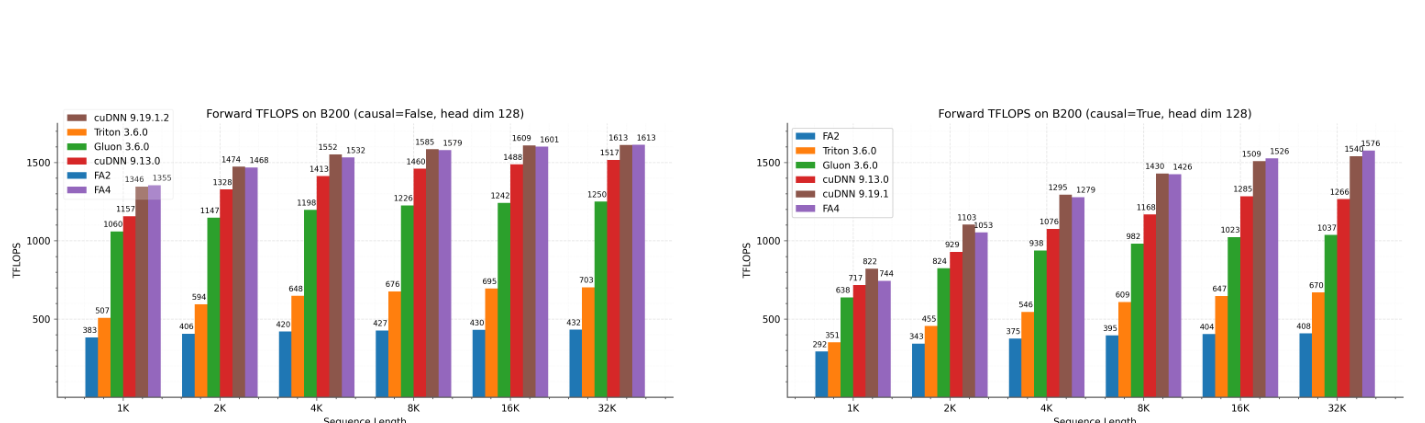
Ted Zadouri 외, FlashAttention-4 v1, PDF 15쪽 그림 4, CC BY-NC-SA 4.0. 그래프 영역만 잘랐으며 그래프 내용은 바꾸지 않았다. 이미지를 누르면 크게 볼 수 있다.
가로축은 시퀀스 길이, 세로축은 초당 부동소수점 연산량이다. 왼쪽은 비인과 attention, 오른쪽은 인과 attention이며 두 그래프 모두 head 차원 128이다. 한 길이의 가장 높은 막대를 전체 모델의 가속 비율로 읽으면 안 된다.
이것은 모델 전체 학습 시간의 배율이 아니다. 같은 그림의 캡션은 후속 cuDNN 버전이 일부 기법을 받아들여 비슷한 성능에 이르렀다고 덧붙인다. 15쪽 §5·그림 4
FP4는 왜 행렬곱만 바꿔서는 끝나지 않나
Robert Hu의 9월 보고서는 먼저 추론용 전방과 학습용 인과 attention을 분리한다. 전방의 full FP4는 attention 안의 Q,K,P,V 네 피연산자가 FP4라는 뜻이다. 모델의 선형 변환(projection), 정규화, 손실 계산까지 전부 FP4라는 뜻이 아니다.
특히 P는 입력에서 읽는 피연산자가 아니라 QKᵀ 점수를 softmax로 바꿔 커널 안에서 새로 만들어야 하는 피연산자다. FP4 행렬곱 자체가 짧아질수록 점수의 최대값 계산, 확률 표현, 스케일 기록, 다음 PV가 읽을 수 있다는 신호를 보내는 일이 지연을 결정한다. FP4 보고서 v1, 1–2쪽 §1 5쪽 §3.1
제안한 Direct-P는 이 중 점수에서 FP4 확률 P를 만드는 구간을 줄인다. 점수를 먼저 높은 정밀도의 지수값으로 만든 다음 4비트 코드로 버리는 대신, 점수에서 지수 2비트·가수 1비트를 쓰는 E2M1 표현의 반올림 구간을 바로 고른다. 여기서 NVFP4와 MXFP4는 여러 값이 스케일을 공유하는 서로 다른 4비트 표현 방식이다. Q,K에는 NVFP4, P,V에는 32개 값이 2의 거듭제곱 스케일을 공유하는 MXFP4를 쓴다. 이 선택은 표현 범위와 코드 생성 비용의 절충이다.
값이 0으로 양자화되거나 코드 경계가 달라질 수 있으므로 2022년의 정확한 attention과는 다른 근사 연산이다.
분자 PV를 계산할 때 쓴 반올림 확률과 분모를 계산할 때 쓴 확률이 다르면 그 차이 때문에 출력 오차가 더 생긴다. Direct-P는 분모도 같은 코드와 스케일에서 합산해 이 불일치를 피한다. FP4 보고서 v1, 6–10쪽 표 2–4·§4.2–4.3
논문의 GB200 비인과 전방 실험에서는 시퀀스 길이 8192, head 64개, 차원 128인 모양에서 Direct-P fast 커널이 BF16 기준 1.611488 ms에서 0.758336 ms로 줄어 2.125배 빠르다. 본문과 초록의 최대 2.13배는 이 값을 반올림한 것이다. 같은 보고서의 GB200 D128 아홉 모양에서 fast의 기하평균 속도 배율은 2.023배다.
다만 입력 Q/K/V를 미리 양자화하는 시간과 선택적인 키·값 재배열은 커널 측정에 들어 있지 않다. 이 숫자를 전체 추론 지연으로 읽을 수 없다. FP4 보고서 v1, 11–14쪽 §5.2–6.2·표 7 15쪽 그림 4
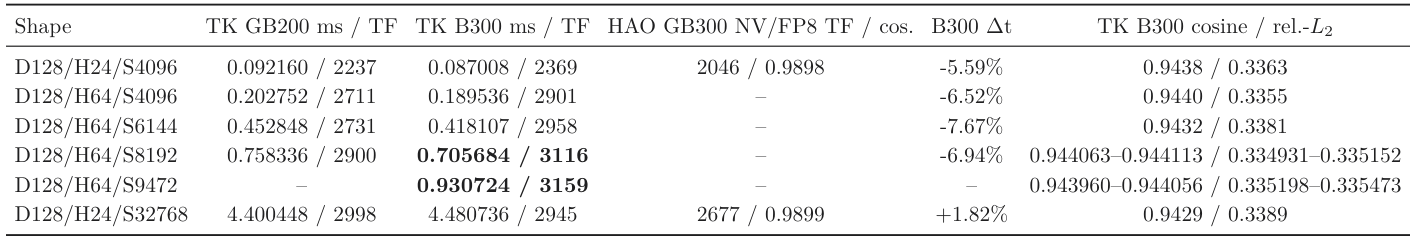
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 14쪽 표 7, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
D/H/S는 head 차원·head 수·시퀀스 길이다. D128/H64/S8192 행에서 GB200 시간 0.758336 ms를 찾을 수 있다. 오른쪽은 B300의 시간·오차와 다른 연구의 GB300 보고값을 나란히 둔 열이므로, 하드웨어를 섞어 GB200에서의 2.125배를 재계산해서는 안 된다.
GB200, D128/H64/S8192 | 전방 커널 시간 |
|---|---|
| BF16 비교 기준 | 1.611488 ms |
| Direct-P fast | 0.758336 ms |
| 기준 시간 / fast 시간 | 약 2.125배 |
위 작은 표는 이 글의 비교에 필요한 한 모양만 모았다. BF16 기준 시간은 같은 보고서의 해당 실험값이며, 원문 표 7의 다른 GPU 열에서 가져온 값이 아니다.
줄어든 시간과 함께 오차도 살펴보자. 이 보고서의 독립 연산자 실험에서 fast의 평균 BF16 대비 cosine은 약 0.944, relative-L2는 약 0.337인 반면, 비교 대상인 FP8 확률 경로의 평균 cosine은 약 0.990이다. cosine은 방향의 일치를, relative-L2는 기준 출력 크기에 대한 차이의 크기를 본다. 한 지표만으로 품질을 판정하기 어렵다.
같은 가중치·입력을 넣은 ViT 실험에서는 길이 4096에서 fast와 BF16의 top-1 정확도가 모두 88.5%였지만, 예측 일치는 95.5%였다. 또 Wan 비디오 실험에서는 20단계로 누적했을 때 BF16 출력과의 차이가 더 커졌다.
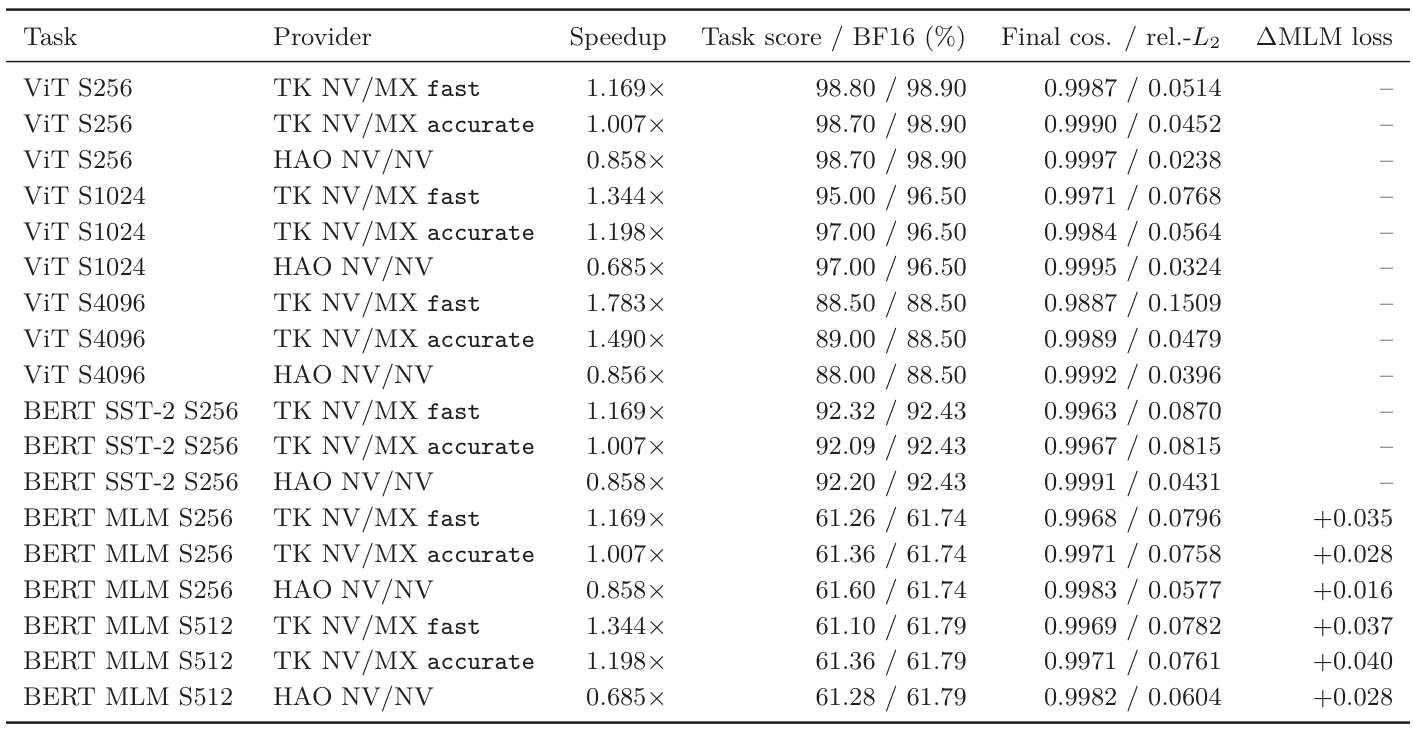
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 17쪽 표 8, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
Task score / BF16 열은 낮은 정밀도 경로와 BF16 경로의 과제 점수다. ViT S4096의 fast 행은 88.50 / 88.50으로 같지만, 오른쪽 출력 오차는 0이 아니다. 이 표의 Speedup은 모델 전체가 아니라 해당 attention 모양의 커널 속도다.
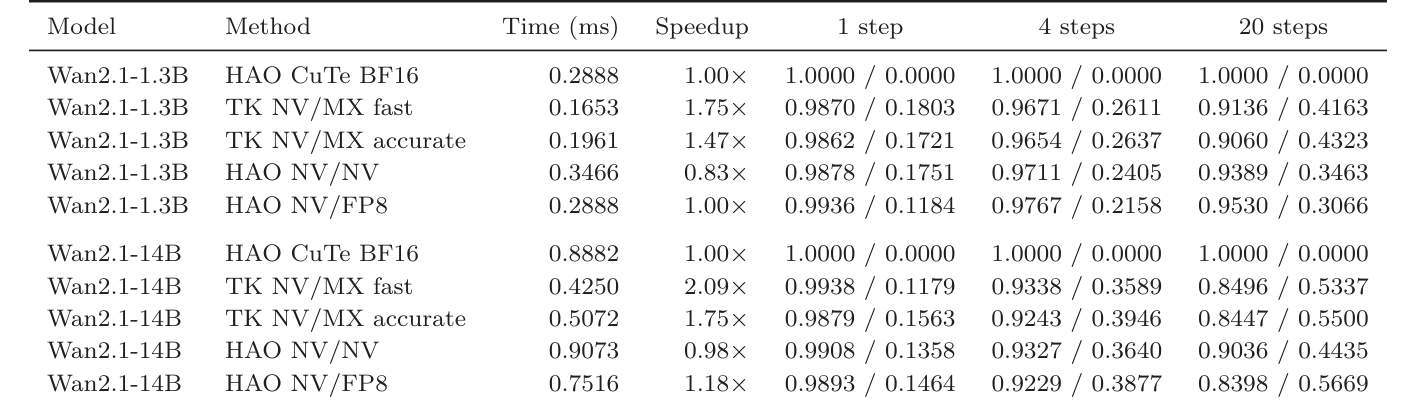
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 17쪽 표 9, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
열의 1 step, 4 steps, 20 steps를 따라가면 같은 근사가 반복될 때의 차이를 볼 수 있다. Wan2.1-14B의 fast 행은 BF16 대비 cosine이 0.9938 → 0.9338 → 0.8496, relative-L2가 0.1179 → 0.3589 → 0.5337로 변한다. 단일 연산의 작은 차이가 여러 단계 뒤에도 작다고 가정할 수 없는 사례다. 영상의 사람이 느끼는 품질을 이 두 지표만으로 판정한 결과는 아니다.
고정 입력에서 한 과제의 정확도가 같았다는 사실은 일반적인 FP4 추론 안전성이나 긴 생성 품질을 증명하지 않는다. FP4 보고서 v1, 13–18쪽 §6.1–6.4·표 8–9
학습에서는 FP4 확률을 그대로 밀어붙이지 않았다
역전파는 전방에서 만든 정보를 다시 써야 한다. 9월 보고서의 인과 학습 경로는 양자화된 Q/K, 스케일, 각 행의 지수 합에 로그를 취한 값(log-sum-exp)을 저장한 뒤 역방향에서 확률을 재구성한다.
하지만 안정적으로 유지한 학습 경로의 P,V와 여러 기울기 피연산자는 FP8이다. 학습된 QKV·출력 projection의 정밀도도 별도 변수다. 저자들이 exact라고 부르는 역방향 재구성은 양자화된 전방 피연산자에 대한 정확성이지 원래 BF16 입력에 대한 무손실 복원이 아니다. FP4 보고서 v1, 19–22쪽 §7.1–7.3·표 11
원문 표 11의 정밀도 계약에서 이 구분에 필요한 항목을 추리면 다음과 같다.
| 연산 경계 | 사용한 표현 |
|---|---|
| 학습된 QKV·출력 선형 변환 | E4M3 대조 경로 또는 NVFP4 처리량 경로; FP32 누적 |
전방의 QKᵀ | NVFP4 Q,K |
전방의 PV | 유지한 학습 경로에서는 FP8 P,V |
| 역방향의 확률 복원 | 저장한 양자화 Q,K, 스케일, log-sum-exp |
| 최종 기울기 출력 | FP32 누적 뒤 BF16 dQ,dK,dV |
“FP4 학습”이라는 한 단어로 이 경계를 지우면, 확률 피연산자까지 FP4였는지와 선형 변환의 정밀도까지 함께 바뀌었는지를 놓친다.
측정에 어디까지 포함했는지에 따라 속도 배율은 크게 달라진다. GB200의 결과를 범위별로 나누면 다음과 같다. 속도 배율이 1보다 작으면 비교 기준보다 느리다는 뜻이다.
| 측정 범위 | 비교 결과 | 읽을 때 구분할 것 |
|---|---|---|
| 단독 역방향의 핵심 재구성 커널 | BF16 대비 1.405배 | 커널 자체의 실행 시간 |
출력 기울기 dO와 통계 생성까지 포함한 역방향 경로 | 0.986배 | 필요한 준비 비용을 넣으면 이득이 사라짐 |
| 선형 변환·회전 위치 부호화(RoPE)·전방·역방향을 포함한 attention 하위층 | 2.656 → 2.133 ms, 1.245배 | attention 주변 연산까지 포함 |
8B 모델의 단일 GPU 전체 업데이트, FP8 P/V 경로 | 854.516 → 751.722 ms, 1.137배 | 아래에 적은 합성 토큰·배치 조건의 전체 업데이트 |
마지막 행은 매개변수 80억 개의 모델(8B), 길이 4096, 로컬 배치 4에서 얻은 값이다. 합성 토큰으로 짧게 실행한 성능 실험이므로 학습 품질 결과로 읽을 수 없다. 커널의 1.405배를 전체 학습 속도에 그대로 적용해서도 안 된다. FP4 보고서 v1, 21쪽 표 12 22쪽 표 13 23–24쪽 표 14
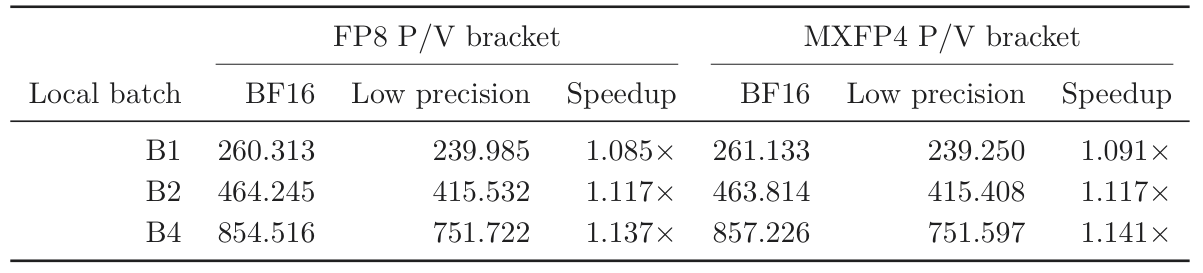
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 25쪽 표 14, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
왼쪽 묶음은 FP8 P/V, 오른쪽 묶음은 MXFP4 P/V이고 각자 인접한 BF16 기준이 있다. B4의 FP8은 854.516 → 751.722 ms, MXFP4는 857.226 → 751.597 ms다. 속도는 비슷해도 아래의 긴 학습 결과까지 같지는 않았다. B1/B2/B4는 로컬 배치 크기이며 표의 시간 단위는 ms다.
빠른 업데이트와 끝까지 진행되는 학습은 다르다
실제로 MXFP4 P/V를 쓴 시험 경로는 짧은 업데이트 시간만 보면 FP8과 거의 같았지만, 보고서가 시험한 분산 학습 궤적은 모두 발산했다.
반대로 저자들이 남긴 FP8 P/V 경로와 BF16 대조군은 같은 데이터 순서로 약 1,000억 토큰 일정을 마쳤다. 공통 로그 지점의 중앙 처리량은 GPU당 21,853→24,303 token/s, 비율로 1.112배였다.
마지막 공통 검증 지점의 손실은 BF16 2.3048, FP8 경로 2.3948로 같지 않았다. 또한 각 경로는 학습 궤적이 하나씩이라 반복 실행 간 변동성을 추정할 수 없다.
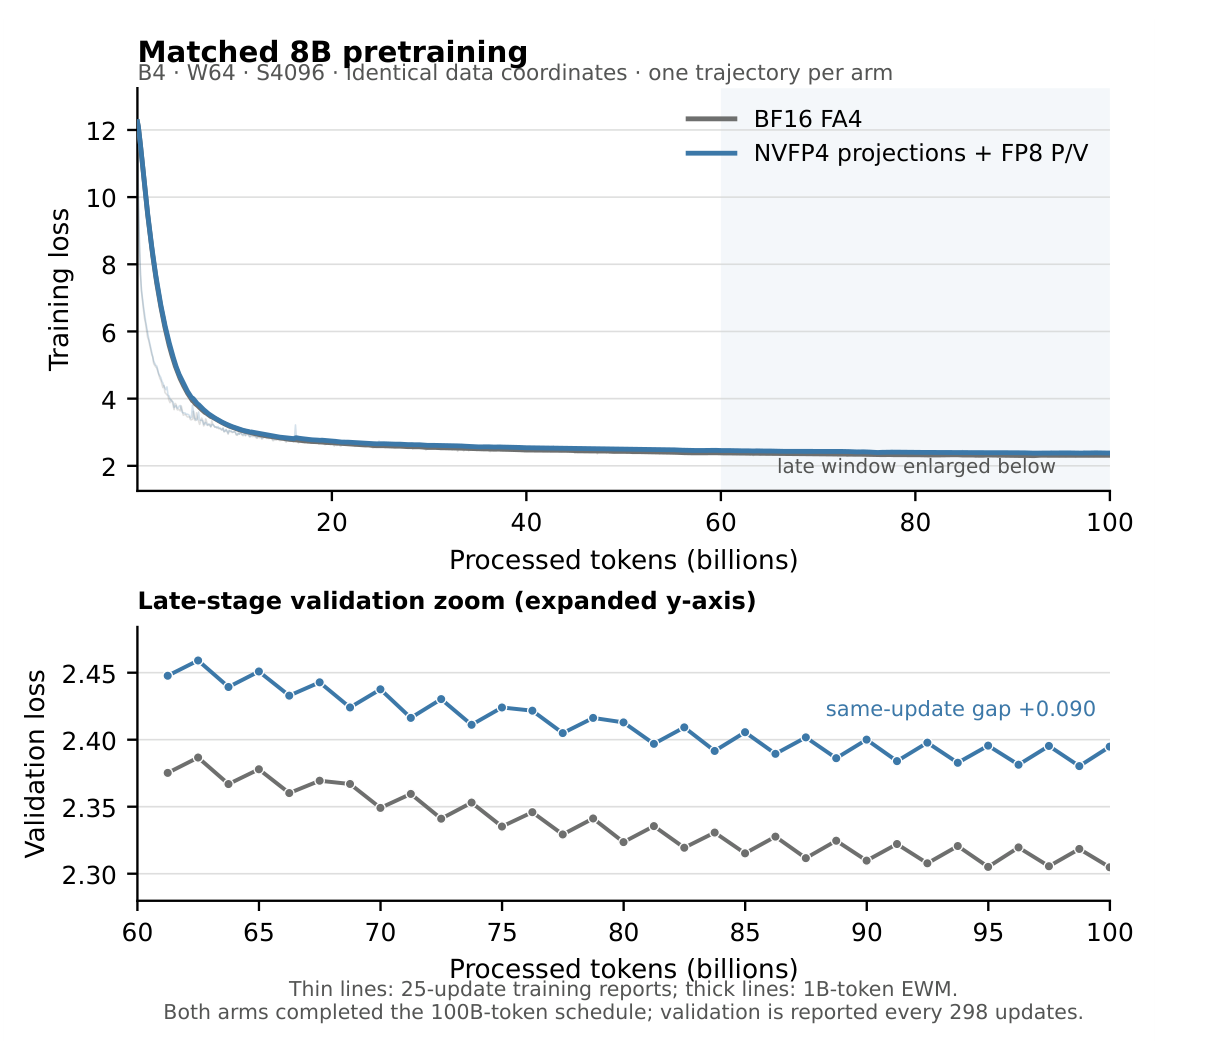
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 27쪽 그림 10, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
가로축은 처리한 토큰 수이고, 회색은 BF16 기준, 파란색은 NVFP4 선형 변환과 FP8 P/V를 쓰는 경로다. 위의 전체 학습 손실에서는 곡선이 가까워 보이지만, 아래 확대된 검증 손실에서는 파란 곡선이 더 높다. 마지막 공통 검증값 2.3948 − 2.3048 = 0.0900의 차이를 아래 패널에서 확인할 수 있다. 각 경로가 한 번의 학습 궤적이라는 조건도 함께 읽어야 한다.
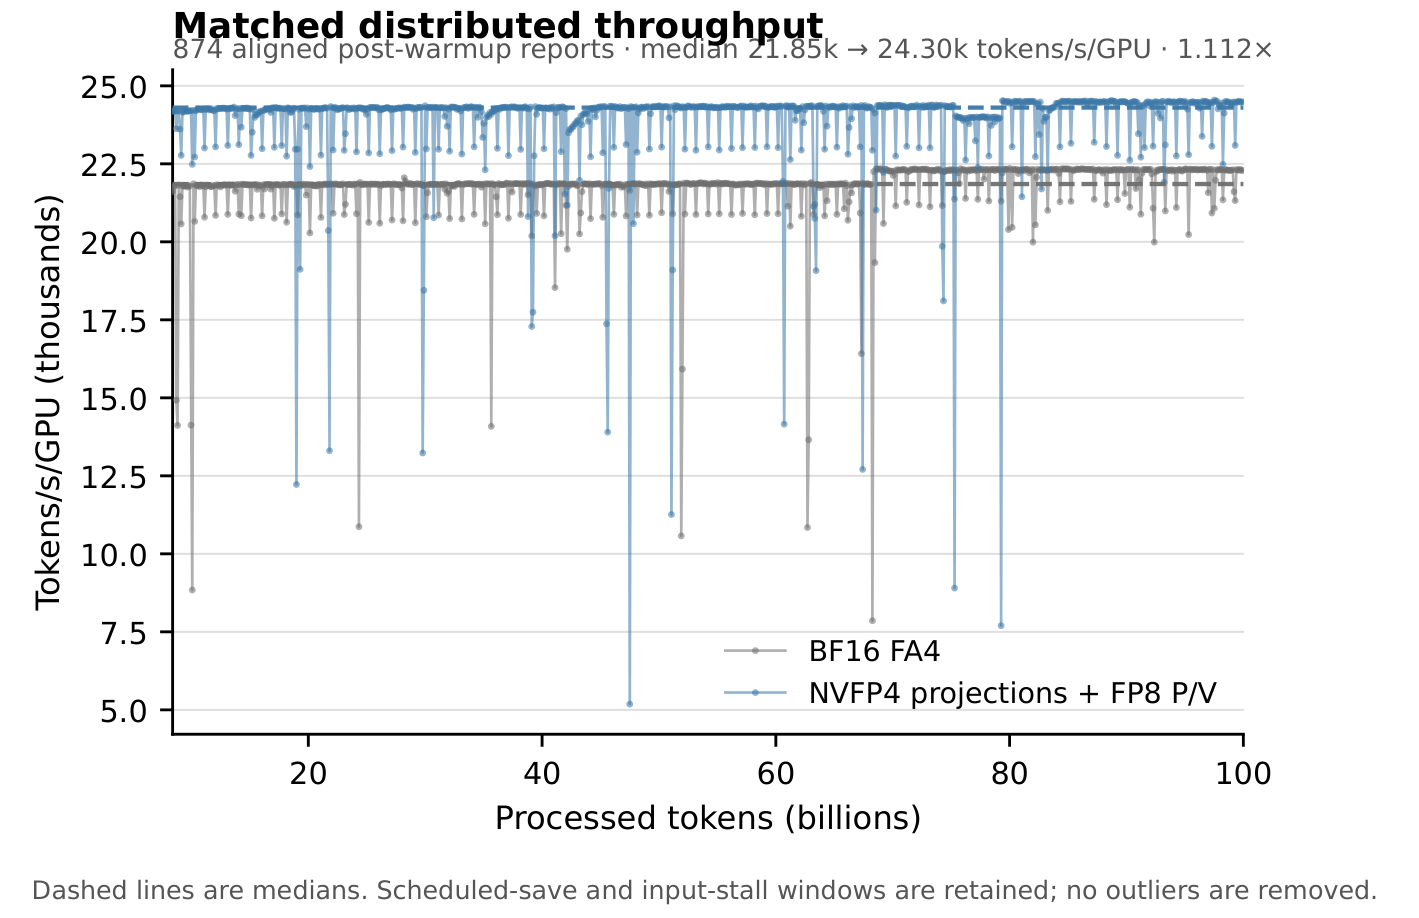
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 28쪽 그림 11, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
처리량 그림의 세로축은 GPU당 초당 토큰 수이며 천 단위다. 점선은 각 경로의 중앙값으로 약 21.85k와 24.30k다. 입력 대기와 체크포인트 시점의 낮은 관측값도 남겨 두었다. 이 그림은 처리량의 개선을 뒷받침하지만, 바로 위 검증 손실 그림의 차이를 없애지는 않는다.
저자들은 MXFP4 실패를 한 명령어의 단독 원인으로 확정하지 않았고, projection 정밀도도 동시에 달라진 경로에서 검증 손실 격차를 attention 하나의 탓으로 돌리지 않았다. FP4 보고서 v1, 24–28쪽 §7.6–7.7·그림 10–11 부록 G.8, 49–51쪽
다음 최적화 대상을 고르는 법
세 연구는 줄이려는 비용부터 다르다. ‘버전별 최고 속도’만 나란히 놓으면 그 차이를 놓친다. 2022년의 병목은 거대한 중간 행렬의 HBM 왕복이었다. FA4가 보는 Blackwell의 병목은 온칩 공유 메모리와 지수 계산, 그 작업을 행렬곱과 겹치는 일정이다. FP4 후속 보고서는 더 빠른 행렬곱 뒤에 남는 확률 피연산자의 준비와 TMEM 소유권까지 추적한다.
실제로 저자들이 마지막 Direct-P 커널에서 거의 모든 확률 생성 작업을 빼 본 정답을 계산하지 않는 진단은 실행 시간을 5.23%만 줄였다. 남은 시간을 다항식 하나로 없앨 수 없다는 근거이고, 추가 점수 버퍼나 다른 PV 발행 단위는 아직 측정된 개선이 아니라 제안이다. FlashAttention v1, 6쪽 그림 2 FA4 v1, 10–12쪽 표 3 FP4 보고서 v1, 28–30쪽 표 15–17·§8.4–8.5
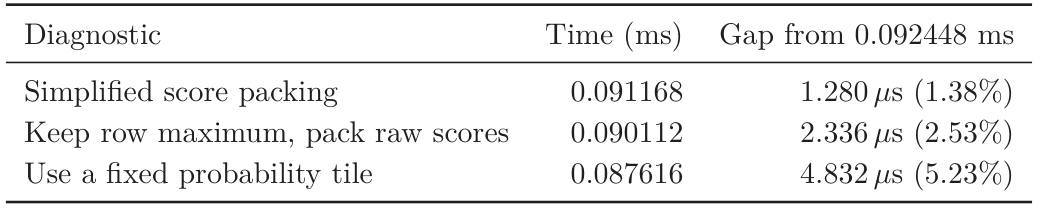
Robert Hu, Hardware-Aware FP4 FlashAttention-4 v1, PDF 30쪽 표 17, CC BY 4.0. 표·그림 영역만 잘랐으며 내용은 바꾸지 않았다. 누르면 확대할 수 있다.
유효한 기준 실행은 0.092448 ms다. 확률을 고정값으로 대체한 마지막 행은 0.087616 ms로 4.832 μs, 5.23%만 줄어든다. 이 행은 attention 정답을 계산하는 구현이 아니므로 새로운 성능 기록으로 채택할 수 없다. 확률 계산을 더 싸게 만드는 것만으로 남은 실행 시간 전체를 없애기 어렵다는 진단이다.
자신의 모델에 적용하려면 어디까지 실행 시간을 재고 어떤 오차를 비교할지부터 정해 보자. 같은 N, head 차원, 마스크, GPU에서 attention 커널을 재는가, 양자화와 projection까지 포함하는가, optimizer와 통신이 들어간 전체 업데이트인가? 전방 출력의 cosine뿐 아니라 크기 오차와 실제 과제 결과를 보았는가?
학습이면 한 번의 빠른 업데이트를 넘어 같은 토큰 지점의 검증 손실과 여러 궤적을 확인했는가? 측정 경계가 달라지는 순간, 앞 문장의 ‘2배’는 다음 문장의 ‘2배’가 아니다. FP4 보고서 v1, 10쪽 표 6 30–31쪽 §8.5
참고 논문
- Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, Christopher Ré, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, arXiv:2205.14135v1, 2022-05-27.
- Ted Zadouri, Markus Hoehnerbach, Jay Shah, Timmy Liu, Vijay Thakkar, Tri Dao, FlashAttention-4: Algorithm and Kernel Pipelining Co-Design for Asymmetric Hardware Scaling, arXiv:2603.05451v1, 2026-03-05.
- Robert Hu, Hardware-Aware FP4 FlashAttention-4, arXiv:2609.04105v1, 2026-09-03.