GLIE: Generative Late-Interaction Embeddings — Mohamed Eltahir 외 | 후보만 복원하는 문서 검색
목차
이미지 문서 한 쪽을 검색하려고 약 1,000개의 벡터를 저장한다. 저장 공간을 줄이려고 네 개만 남기면, 질의와 맞는 표의 셀이나 그림 속 글자가 빠질 수 있다. 검색할 때는 네 개로 모든 쪽을 훑고, 추린 후보에서만 약 1,000개를 다시 만들어 점수를 매기면 어떨까?
Mohamed Eltahir 외 7명의 Generative Late-Interaction Embeddings For Visual Document Retrieval은 바로 이 선택을 시험한다. 2026년 9월 10일 제출된 arXiv v1 프리프린트이며, 아래 쪽수는 16쪽짜리 v1 PDF를 가리킨다.
여기서 GLIE(Generative Late-Interaction Embeddings)는 한 쪽에 저장하는 작은 벡터 집합과, 후보 쪽의 벡터를 다시 만드는 공유 디코더를 함께 뜻한다. 저장 벡터를 줄인 뒤, 검색에 필요한 정보를 어느 단계에서 다시 만들어 내는지 따라가 보자. 단일 벡터와 다중 벡터의 우열을 전반적으로 비교하려는 글은 아니다. 논문 PDF pp.1–3
평균 벡터의 길이가 점수를 바꾼다
논문의 출발점은 ColPali v1.3이 문서 한 쪽에서 만드는 N=1,031개의 패치 벡터다. 각 벡터의 차원 D는 128이다. 질의를 m개 벡터로 표현하면 MaxSim은 질의 벡터마다 문서 벡터 중 내적이 가장 큰 하나를 고르고, 그 최대값을 모두 더한다.
예를 들어 질의에 두 벡터가 있다면 첫째 질의 벡터의 최고 점수와 둘째 질의 벡터의 최고 점수를 더한다. 모든 패치 벡터를 저장하는 데 공간이 들지만, 질의 벡터 하나의 점수에는 가장 큰 내적만 쓰인다. 논문 PDF §3.1, 식 (1), pp.3–4
X = {x₁, …, xₙ}: 한 쪽의 원본 패치 벡터,  n = 1,031
Q = {q₁, …, qₘ}: 질의 벡터
MaxSim(Q, X) = Σⱼ maxᵢ ⟨qⱼ, xᵢ⟩i는 문서 벡터 번호, j는 질의 벡터 번호다. ⟨qⱼ, xᵢ⟩는 두 벡터의 내적, Σⱼ는 모든 질의 벡터에 대한 합을 뜻한다.
내재 차원은 좌표를 몇 개 적는지가 아니라, 데이터가 실제로 몇 방향으로 변하는지를 나타낸다. 가령 3차원 좌표로 기록한 점들이 평평한 한 면 위에만 놓인다면, 그 면 위의 두 좌표만으로 위치를 표현할 수 있다. 문서 벡터도 저장된 좌표 수에 비해 변화가 적은 공간에 모인다면 압축할 여지가 있다는 것이 이 연구의 출발점이다. 실제 벡터가 모두 한 평면에 있다는 뜻은 아니다.
논문에서 조사한 세 인코더의 출력 벡터 길이는 1이다. 저자들은 6,729쪽을 대상으로 TwoNN 추정기를 적용해 한 쪽 벡터 구름의 내재 차원 중앙값을 ColPali 4.9, ColQwen2 5.1, Nemotron v2 6.1로 보고한다. 원래 벡터 공간의 차원은 앞의 두 모델에서 128, 마지막 모델에서 3,072다.
| 인코더 | 저장된 벡터의 좌표 수 | 내재 차원 중앙값 |
|---|---|---|
| ColPali | 128 | 4.9 |
| ColQwen2 | 128 | 5.1 |
| Nemotron v2 | 3,072 | 6.1 |
원문 표 2의 인코더별 중앙값을 모은 표다. TwoNN은 가까운 두 이웃까지의 거리 관계로 국소 차원을 추정하는 방법이다. 원문의 데이터셋별 세부 열은 생략했다.
이 값은 실험 표본에서 국소적인 차원을 추정한 결과다. 모든 이미지 문서를 정확히 5~6개 변수로 복원할 수 있다고 해석해서는 안 된다. 논문 PDF 표 2·§3.1, p.4
k-means는 벡터들을 k개 묶음으로 나누는 방법이다. 단위 벡터를 이 방법으로 묶으면 중심 c는 구성 벡터의 평균이므로 보통 길이가 1보다 짧다. 한 클러스터의 벡터가 (1, 0)과 (0, 1)인 설명용 2차원 사례를 보자. 중심은 (0.5, 0.5), 길이는 약 0.707이다. (1, 0) 방향의 질의 한 벡터에는 원본 MaxSim이 1, 중심의 점수가 0.5, 길이를 1로 만든 중심 (0.707, 0.707)의 점수가 약 0.707이다. 정규화만으로 누락된 점수 일부를 되찾는다.
반대로 질의가 (0.707, 0.707) 방향이면 정규화한 중심의 점수 1은 실제 두 원본 벡터의 최고 점수 약 0.707보다 크다.
중심의 길이를 늘리면 점수를 보완할 수는 있어도 원본 점수를 정확히 되찾지는 못한다. 논문도 정규화한 중심이 원본의 최고 점수보다 높은 값을 낼 수 있다고 명시한다. 논문 PDF 명제 1·§3.1, p.4
아래 코드는 그 산술만 확인한다. 모델 학습이나 논문의 검색 실험을 재현하지 않는다.
from math import isclose, sqrt

x = ((1.0, 0.0), (0.0, 1.0))
c = tuple(sum(v[d] for v in x) / len(x) for d in range(2))
u = tuple(v / sqrt(sum(t * t for t in c)) for v in c)
dot = lambda a, b: sum(v * w for v, w in zip(a, b))
score = lambda q, vectors: max(dot(q, v) for v in vectors)

assert isclose(score((1, 0), x), 1.0)
assert isclose(score((1, 0), (c,)), 0.5)
assert isclose(score((1, 0), (u,)), 1 / sqrt(2))
assert isclose(score(u, x), 1 / sqrt(2))
assert isclose(score(u, (u,)), 1.0)
원문에는 클러스터 안 벡터들의 평균 제곱 거리 1−‖c‖²가 중심 길이와 연결된다는 식도 있다. 멀리 퍼진 클러스터일수록 중심이 더 안쪽으로 들어간다는 뜻이다. GLIE는 여기서 중심의 길이를 보정하는 첫 단계를 시작한다.
ViDoRe v1 열 개 부분집합의 매크로 평균에서 k=4일 때 원시 k-means는 nDCG@5 0.512, 중심을 정규화한 학습 없는 단계는 0.605다. +0.093은 정규화의 실험 결과이고, 앞의 2차원 숫자는 그 방향을 설명하는 별도 예제다. k=64에서 정규화 증가분은 0.030으로 줄었다. 논문 PDF 표 7, p.10
원문 표 7의 양 끝 예산을 비교하면 정규화가 아낀 손실과 학습·복원의 기여를 나누어 볼 수 있다. 아래 값은 같은 평가의 nDCG@5다.
| 누적 구성 | 벡터 4개 | 벡터 64개 |
|---|---|---|
| 원시 k-means | 0.512 | 0.779 |
| 중심 정규화 추가 | 0.605 | 0.809 |
| 코드 학습 추가 | 0.641 | 0.809 |
| 후보 복원 추가 | 0.657 | 0.811 |
벡터 4개에서는 정규화로 0.093, 이후 코드 학습으로 0.036, 복원으로 0.016이 더해진다. 벡터 64개에서는 학습과 복원의 추가 이득이 작다. 나머지 네 저장 예산 열은 생략했으며 증가분은 위 값에서 계산했다.
네 벡터는 색인이자 복원의 입력이다
정규화한 클러스터 중심 U에는 평균만 남는다. 그 주변에 원래 벡터들이 어떻게 퍼져 있었는지는 알 수 없다. GLIE는 인코더를 고정한 채, 전체 원본 벡터 X를 읽는 cross-attention 보정기를 학습해 저장할 k개의 코드 벡터 C를 만든다. 보정기의 마지막 투영을 0으로 초기화하므로 학습 시작 시점에는 C=U다.
학습 뒤에도 검색 품질이 수학적으로 항상 정규화 k-means 이상이라는 보장은 없다. 실제 부록에는 일부 부분집합·예산에서 학습 단계의 nDCG@5가 학습 없는 단계보다 낮은 셀이 있다. 논문 PDF §3.4, p.5, 표 10·11, pp.14–15
예를 들어 DocVQA 부분집합에서는 다음 값이 보고됐다. 원문 표 10에서 정규화 단계와 코드 학습 단계의 세 열을 옮겼다.
| 단계 | k=16 | k=32 | k=64 |
|---|---|---|---|
| 정규화한 중심 | 0.413 | 0.466 | 0.500 |
| 학습한 코드 | 0.401 | 0.450 | 0.489 |
여기서는 세 예산 모두 코드 학습 뒤 점수가 낮아졌다. 시작점을 정규화 중심에 맞췄다는 조건은 학습 이후에도 모든 부분집합에서 점수가 오르리라는 보장이 아니다.
온라인 검색에는 두 단계가 있다.
- 후보 선택: 모든 문서는 저장된
k개 코드 벡터만으로 MaxSim을 계산한다. - 후보 복원·재정렬: 상위
L=20쪽만 공유 디코더로 각 쪽의N개 벡터를 생성하고 그 생성된 집합에 대해 MaxSim을 다시 계산한다.
디코더는 각 클러스터의 첫 출력에 원래 코드 벡터를 그대로 넣는다. 같은 질의와 문서라면 생성 집합의 MaxSim은 코드만 쓸 때보다 작아질 수 없다.
그렇다고 최종 순위나 nDCG가 반드시 좋아지는 것은 아니다. 오답 문서의 점수도 올라갈 수 있고, 처음 20위 밖으로 밀린 정답은 복원 단계가 볼 수 없다.
논문의 ‘exact rescoring’은 생성된 N개 벡터에 대한 MaxSim 계산을 가리킨다. 원본 벡터 X의 점수를 정확히 복구한다는 뜻으로 읽으면 실험의 oracle 간격과 맞지 않는다. 논문 PDF §3.5–3.6, pp.5–6, §4.3, p.8
논문의 검색 단계를 다시 그렸다. 1차 검색에서 빠진 쪽은 복원되지 않고, 후보 안의 생성 벡터도 원본과 다를 수 있다. 두 실패 지점을 구분해 읽어야 한다.
디코더는 원본과 출력 벡터의 좌표를 일대일로 맞추는 재구성 오차를 주목표로 삼지 않는다. 질의 토큰별 MaxSim, 후보 간 순서, 오답 문서의 과대 점수, 클러스터의 집합 모양, 여러 방향에서의 극값을 손실 항으로 다룬다. 출력이 평균 좌표에 몰리면 재구성 오차는 작아도, MaxSim 점수를 결정하는 극값을 놓칠 수 있기 때문이다.
출력 벡터는 담당 클러스터의 앵커에서 최대 arctan(0.75)≈37° 범위로 움직이게 설계했다. 이는 복원 벡터가 제멋대로 퍼지는 일을 제한하지만 원본과 동일함을 보장하지는 않는다. 논문 PDF §3.5·§3.7, pp.5–7, 부록 A, p.13
숫자는 저장 단위와 검색 단계를 나눠 읽는다
저자들이 보고한 ViDoRe v1 열 개 부분집합의 매크로 평균 nDCG@5에서 k=4의 결과는 아래와 같다. nDCG@5는 각 질의의 상위 다섯 결과 품질을 정답 순위에 비춰 정규화한 값이고, 이 표는 그 부분집합별 점수를 같은 비중으로 평균한다.
따라서 이 수치는 전체 질의 3,943개를 하나로 합친 점수와 동일한 정의가 아니다. 평가에는 ViDoRe v1의 모든 질의를 쓰며 학습된 행은 세 학습 시드의 평균이다. 논문 PDF §4.1, p.7, 표 3, p.8, 부록 B, p.13
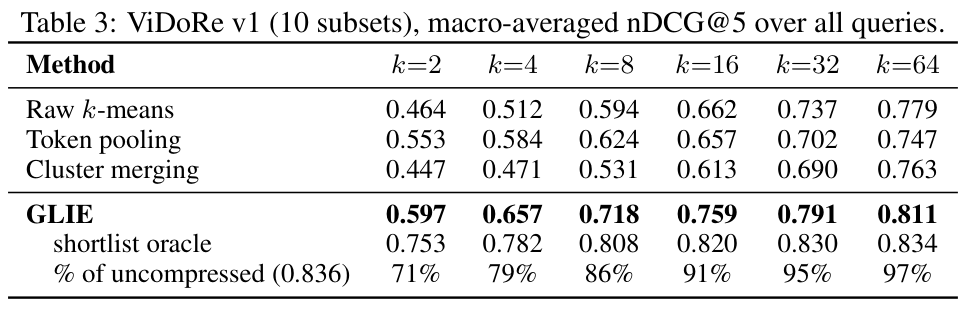
원문 부분 인용: Mohamed Eltahir 외, GLIE v1, PDF 8쪽 표 3. 표 영역만 잘랐으며 수치·행·열은 바꾸지 않았다. 이미지를 누르면 크게 볼 수 있다.
k=4 열에서 GLIE의 0.657과 바로 아래 shortlist oracle의 0.782를 비교하면 된다. 첫 값은 실제 생성 벡터의 결과, 둘째는 같은 후보를 원본 벡터로 평가하는 상한선 실험이다. 아래는 이 열과 후속 분석에서 필요한 값만 모아 한국어로 다시 정리한 표다.
k=4 방식 | nDCG@5 | 원본 0.836 대비 |
|---|---|---|
| 원시 k-means | 0.512 | 61% |
| 기존 학습 없는 비교법 중 최고인 token pooling | 0.584 | 70% |
| 정규화한 중심, GLIE의 학습 없는 단계 | 0.605 | 72% |
| 학습된 코드만 검색 | 0.641 | 77% |
| GLIE 전체, 상위 20쪽 복원 포함 | 0.657 | 79% |
| 원본 1,031개 벡터 | 0.836 | 100% |
표의 70%와 79%는 절대 nDCG 차이가 아니라 각각 0.584/0.836, 0.657/0.836을 반올림한 원본 대비 비율이다.
논문은 ViDoRe v2 네 부분집합에서도 k=4 전체 점수 0.330, 원본 0.517을 보고한다. 비율은 64%로 v1의 79%보다 낮다. ColQwen2를 쓴 v1 반복에서는 0.727/0.883, 약 82%다. 데이터셋과 인코더를 바꾸면 원본 대비 품질도 달라진다. 논문 PDF 표 3·4, p.8, 표 6, p.9, 표 7, p.10
평가 설정 (k=4) | GLIE | 원본 벡터 | 원본 대비 비율 |
|---|---|---|---|
| ColPali · ViDoRe v1 | 0.657 | 0.836 | 약 79% |
| ColPali · ViDoRe v2 | 0.330 | 0.517 | 약 64% |
| ColQwen2 · ViDoRe v1 | 0.727 | 0.883 | 약 82% |
원문 표 3·4·6의 해당 설정만 재구성했다. 비율은 각 행의 GLIE 값을 원본 값으로 나눈 것이다. 데이터셋이나 인코더가 다른 행끼리 절대 점수를 비교해 어느 방식이 더 좋다고 결론 내릴 수는 없다.
저장량도 벡터 개수와 실제 바이트를 구분해야 한다. ColPali 원본은 1,031 × 128 × 2 = 263,936바이트, 곧 약 257.8 KiB다. k=4 GLIE 코드는 bfloat16 벡터 4 × 128 × 2 = 1,024바이트에 클러스터마다 fp16 길이와 uint16 개수를 저장하는 16바이트가 더해져 1,040바이트/쪽이다.
백만 쪽이면 원본 벡터 약 264GB, 코드 약 1.04GB(십진 단위)다. 원문은 원본을 쪽당 257.8 KB, 백만 쪽을 258 GB로 표기해 이 십진 바이트 계산과 일치하지 않는다. 여기서는 바이트 수를 기준으로 환산했다. 두 비교 모두 색인 구조·메타데이터·공유 디코더까지 포함한 서비스 총 저장량은 아니다. 논문 PDF §1, p.2, §4.5, p.9, 부록 A, p.13
작은 학습 비용에 포함되지 않은 것
학습에 걸린 시간은 어디까지 센 값일까? 주 실험에서는 인코더를 고정하고 ColPali 공개 학습 컬렉션 5,000쪽으로 코덱을 학습했다. 저자는 1,250·2,500·5,000쪽의 k=4 성능 차이가 거의 없었다고 보고하며, 한 예산의 코덱 학습에 A100 80GB 한 장에서 2.7분이 들었다고 적는다.
이는 저장 예산 하나당 코덱 적합 시간이다. 원본 인코더의 학습, 전체 문서의 최초 임베딩 생성, 쪽별 k-means와 색인 구축, 질의 지연을 합친 총비용이 아니다. 백본 재학습 없이 기존 임베딩에서 예산을 바꿀 수 있다는 점은 설계상 이점이지만, 원본 벡터 캐시를 버렸다면 다른 예산으로 다시 만드는 운영 비용은 별도로 계산해야 한다. 논문 PDF §4.1·§4.5, pp.7·9, 부록 A, p.13
논문이 재현한 Light-ColPali 미세조정은 같은 데이터 출처의 4,000쌍과 제한된 학습 비용으로 비교한 별도 실험이다. k=4에서 그 행은 0.544, 정규화 k-means는 0.605, GLIE 전체는 0.657이었다.
| 제한된 학습 예산에서의 방법 | k=4 nDCG@5 |
|---|---|
| 논문 저자들이 재현한 Light-ColPali 미세조정 | 0.544 |
| 학습 없는 정규화 k-means | 0.605 |
| 동결된 인코더를 쓰는 GLIE | 0.657 |
원문 표 5의 k=4 열을 재구성했다. Light-ColPali 원저자들의 별도 대규모 학습 결과와는 구별한다.
원래 Light-ColPali 논문은 더 큰 규모로 학습했으므로 이 결과와 조건이 다르다. 저자도 출판된 방법 자체를 반박하는 결과로 읽지 말라고 명시한다. 여기서는 작은 추가 학습 예산을 어디에 썼을 때 효과가 났는가를 비교한 셈이다. 논문 PDF 표 5·§4.4, p.9, 부록 C, p.13
상위 후보를 찾은 뒤에도 남는 간격
k=4, L=20의 v1 결과와 원본 사이에는 nDCG@5로 0.179가 남는다. 같은 후보 집합에서 복원이 완벽하다고 놓은 shortlist oracle을 사이에 두면 두 구간으로 나눠 볼 수 있다.
| 비교 | nDCG@5 변화 | 남은 간격을 해석하는 관점 |
|---|---|---|
| GLIE → 같은 후보의 원본 벡터로 평가 | 0.657 → 0.782, 차이 0.125 | 후보 안의 문서에 대해 생성 벡터가 살리지 못한 점수 |
| 같은 후보의 원본 벡터 → 전체 원본 검색 | 0.782 → 0.836, 차이 0.054 | 첫 단계에서 후보 밖으로 빠진 문서와 관련된 손실 |
oracle은 실제 배포 방식의 성능이 아니라, 후보 선택과 복원 중 어디에서 손실이 생기는지 분리해 보는 실험이다.
간격을 나누면 어느 단계를 살펴볼지 정하기가 쉽다. 다만 디코더를 바꾸기만 하면 0.125를 모두 되찾는다는 보장은 없다. 논문 PDF 표 3·§4.3·그림 4, p.8
후보 수를 20에서 100으로 넓힌 추가 실험에서 실제 GLIE 점수는 0.658 → 0.660으로 거의 움직이지 않았지만, oracle은 0.783 → 0.822로 올라갔다. 저자들은 후보 복원에 계산을 더 써도 현재 디코더로는 그만큼의 품질 개선을 얻지 못했다고 해석한다.
후보 수 L | 실제 GLIE | 같은 후보의 oracle |
|---|---|---|
| 5 | 0.647 | 0.705 |
| 10 | 0.655 | 0.750 |
| 20 | 0.658 | 0.783 |
| 50 | 0.660 | 0.810 |
| 100 | 0.660 | 0.822 |
원문 표 9의 전체 후보 수를 한국어 표로 옮겼다. 이 추가 실험의 L=20 값은 본 실험의 0.657·0.782와 조금 다르므로 앞 표의 수치를 대체하지 않는다.
후보를 다섯 배로 늘린 20 → 100 구간에서 실제 점수는 0.002만 올랐다. 후보 자체의 잠재 품질과 현재 디코더가 끌어낸 품질의 차이가 표에 드러난다.
반면 이 논문에는 실서비스 지연 시간, 초당 질의 수, 디코더가 차지하는 피크 메모리의 비교표가 없다. ‘상위 20쪽만 복원한다’는 구조에서 속도 이득을 예상할 수는 있어도, 이를 측정된 지연 개선으로 옮기면 안 된다. 논문 PDF 표 9·§5, p.10
실제로 도입을 판단한다면 같은 질의와 쪽 집합에서 세 수치를 함께 재보는 편이 좋다. k개 코드로 만든 상위 20쪽에 정답이 들어왔는지, 그 후보를 원본 벡터로 다시 매겼을 때의 품질이 얼마인지, 생성 벡터로 다시 매겼을 때의 품질이 얼마인지다.
첫째가 낮으면 후보 검색을, 둘째와 셋째의 간격이 크면 복원을 살펴야 한다. 여기에 쪽당 저장 바이트와 실제 질의 지연을 함께 기록해야 저장 절약이 서비스 비용 절약으로 이어지는지 판단할 수 있다. 논문의 두 검색 단계와 oracle 실험을 응용해, 도입 전에 직접 확인해 볼 방법이다. 논문 PDF §3.6, p.5, §4.3, p.8
참고 논문
저자는 Mohamed Eltahir, Talal Aloushan, Rose Khairoalsendi, Jana Shata, Mohammed Alhassan, Leen Alrehaili, Tanveer Hussain, Naeemullah Khan이다. 원문·PDF: arXiv:2609.11808v1.